

Что такое связные списки простыми словами?
Автор — Владимир Балун
ex-TeamLead в Яндекс
При изучении алгоритмов связный список часто сравнивают с массивом, однако различия между этими структурами данных не всегда очевидны. Из-за этого возникают сложности при выборе подходящего решения для конкретной задачи.
В этой статье рассмотрим устройство связного списка, разберем операции вставки, удаления и поиска элементов, сравним его с массивом и выясним, в каких случаях связный список оказывается более эффективным.
В этой статье рассмотрим устройство связного списка, разберем операции вставки, удаления и поиска элементов, сравним его с массивом и выясним, в каких случаях связный список оказывается более эффективным.

1. Что такое связный список
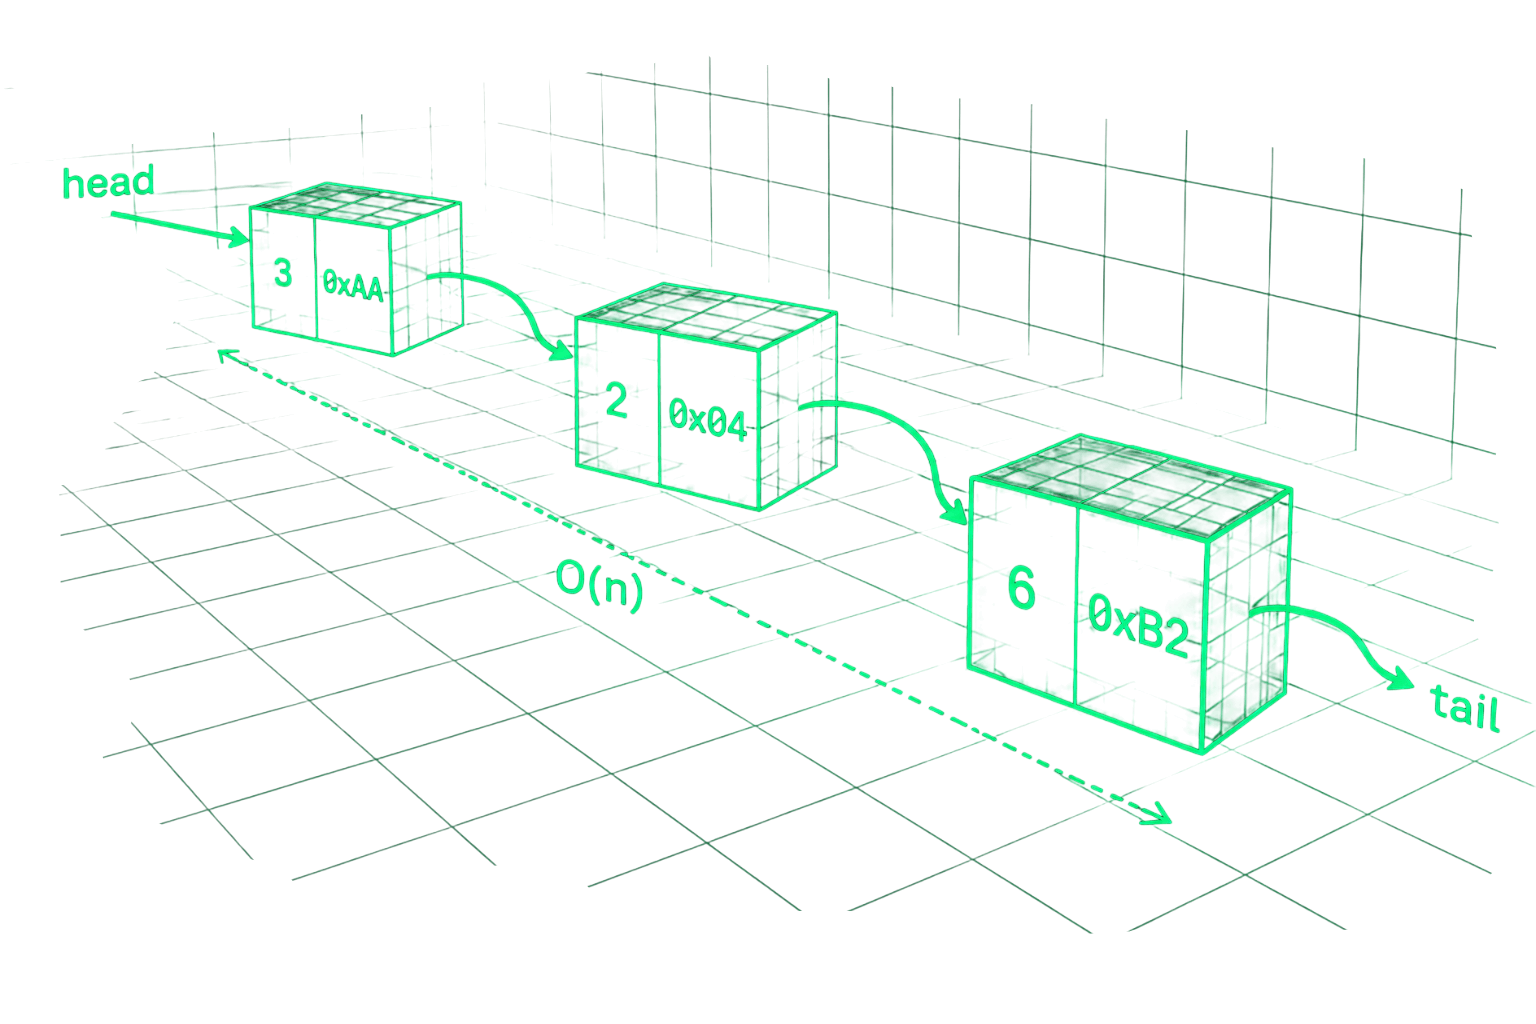
Связный список (linked list) — это структура данных, которая состоит из набора узлов (nodes), каждый из которых хранит значение и ссылку либо указатель на следующий элемент
Пример структуры узла на языке C++:
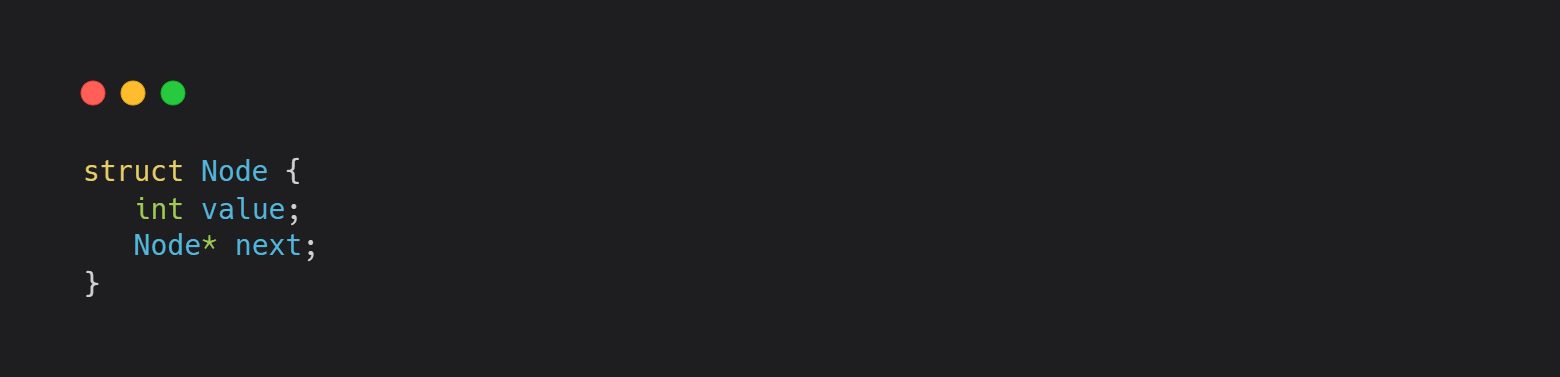
Каждый узел может быть формально описан как структура данных в виде абстрактного псевдокода.
2. Отличия связного списка от массивов
- В отличие от массива, где хранится только последовательность значений, связный список хранит дополнительную метаинформацию в виде указателя на следующий элемент. Это приводит к дополнительным затратам памяти на хранение связей
- Элементы массива располагаются последовательно и непрерывно. В связном списке элементы могут быть размещены в произвольных участках памяти, без необходимости физической последовательности
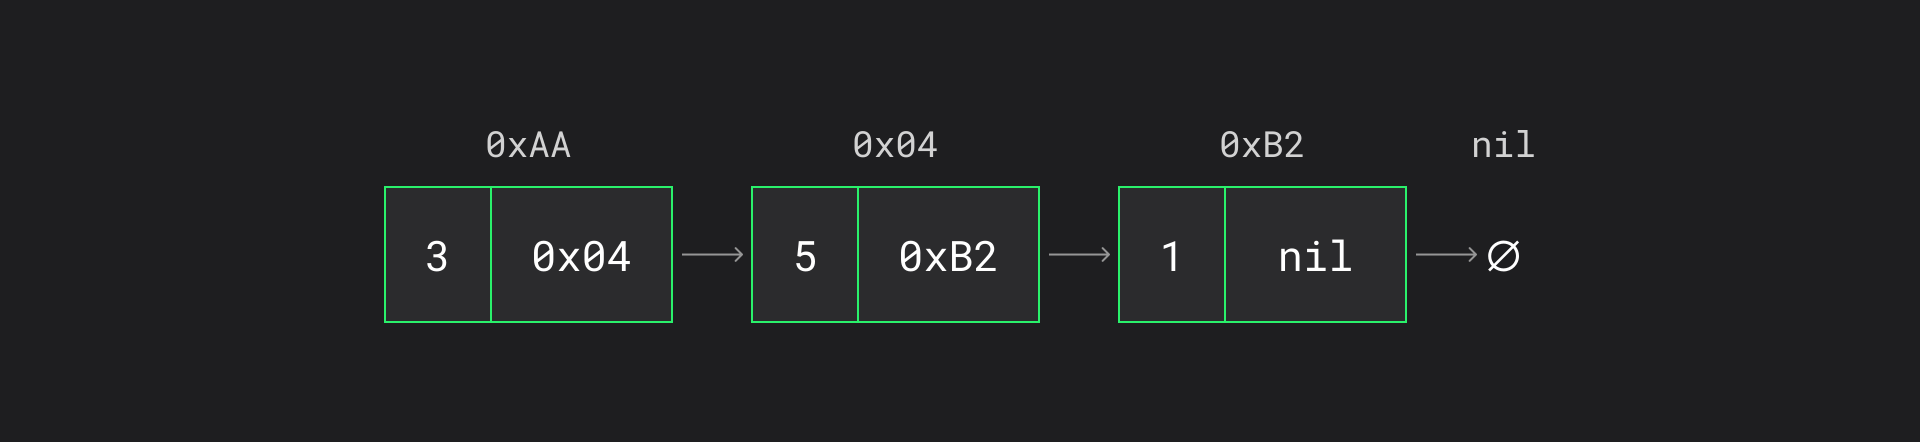
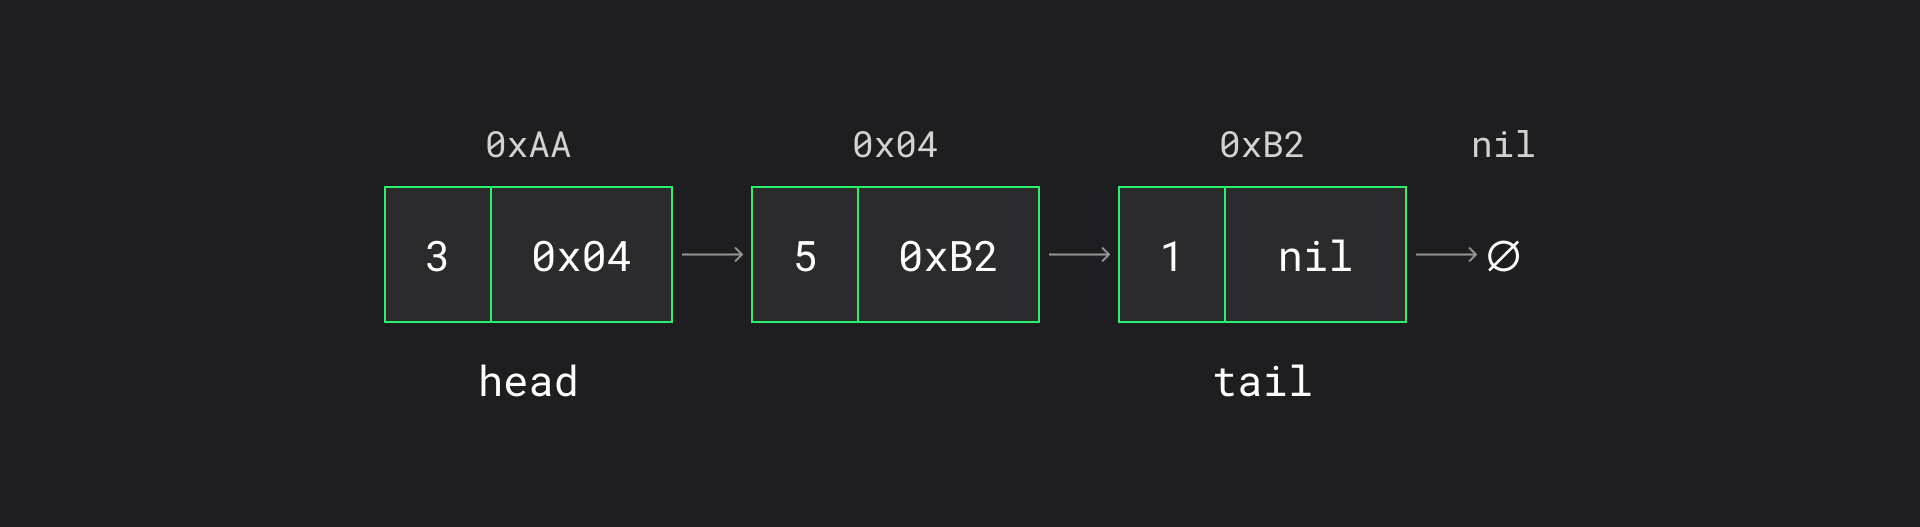
Данные связного списка могут храниться непоследовательно и разрозненно (адреса здесь и в последующих примерах указаны условно исключительно для визуализации)
3. Принцип организации связей
Логическая структура списка формируется исключительно за счет цепочки указателей, а не физического расположения элементов.
Каждый узел содержит ссылку на произвольный адрес памяти, что формирует последовательную логическую цепочку, независимо от физического расположения узлов в памяти.
Каждый узел содержит ссылку на произвольный адрес памяти, что формирует последовательную логическую цепочку, независимо от физического расположения узлов в памяти.
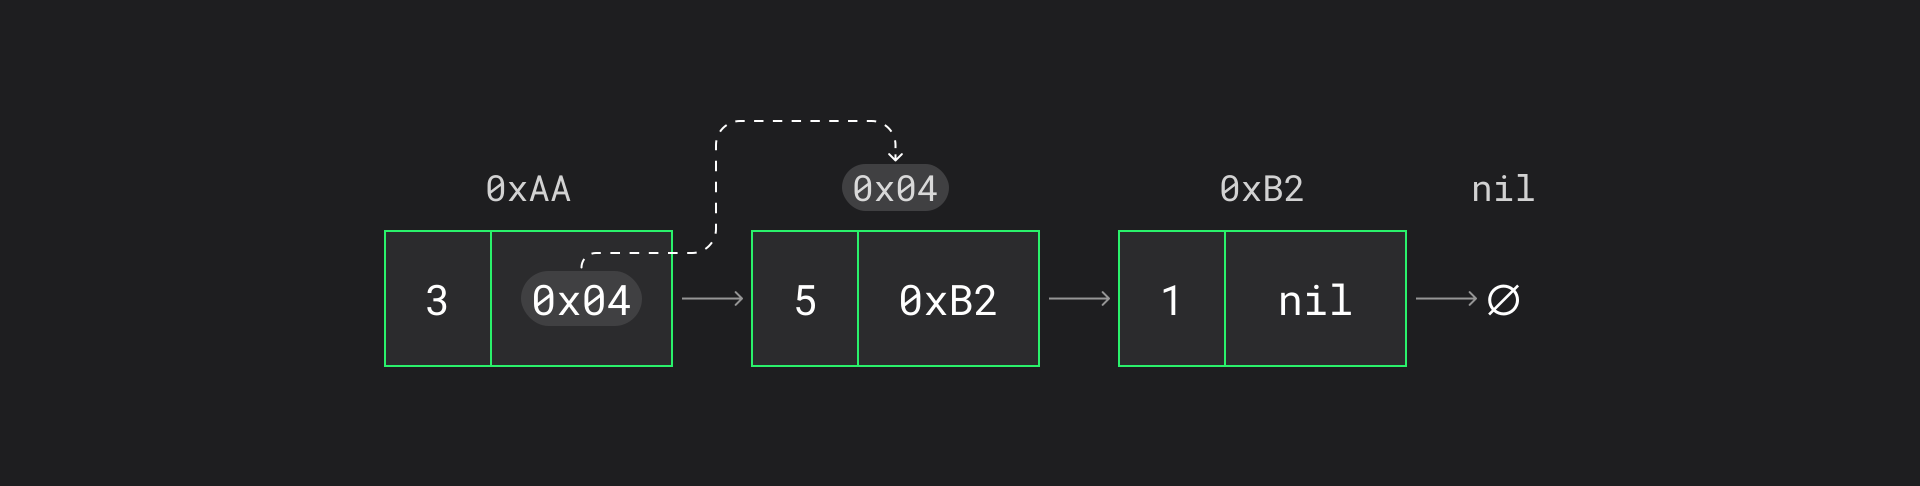
Каждый узел содержит указатель, который ссылается на другой произвольный адрес памяти
В структуре связного списка выделяют 3 ключевых элемента:
Указатель хвоста на следующий элемент показывается значением nil, который обозначает конец структуры данных.
- голова (head) — первый узел списка и точка входа в структуру данных;
- хвост (tail) — последний узел списка;
- указатели (next, prev) — показывают, куда ссылается данный узел.
Указатель хвоста на следующий элемент показывается значением nil, который обозначает конец структуры данных.
4. Вставка элемента
Вставка в начало связного списка
Представим, что мы хотим добавить элемент в начало связного списка. Операция включает три последовательных действия: создание нового узла, переназначение указателя next и обновление указателя head.
Шаг 1. Создание нового элемента
На первом этапе создаем новый элемент (например, со значением = 2), который размещается по некоторому адресу памяти (например, 0xCC в рамках примера).
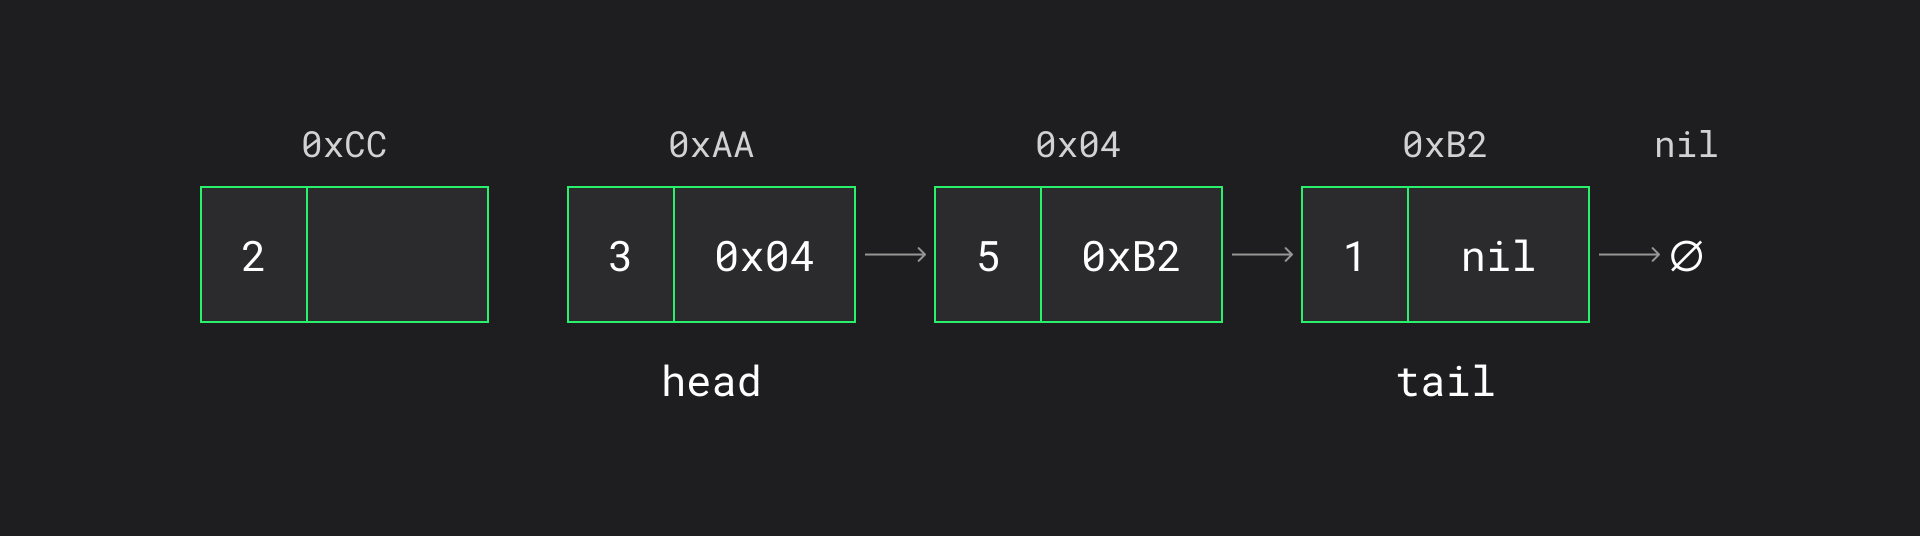
Создается новый элемент со значением «2» и адресом памяти 0xCC
На данном этапе новый элемент существует, но его поле указателя ещё не ссылается на какие-либо элементы связного списка.
Шаг 2. Установка связи с текущей головой списка
Следующим шагом выполняется установление связи между новым узлом и текущей структурой данных. Для этого указатель нового узла перенаправляется на текущую голову списка.
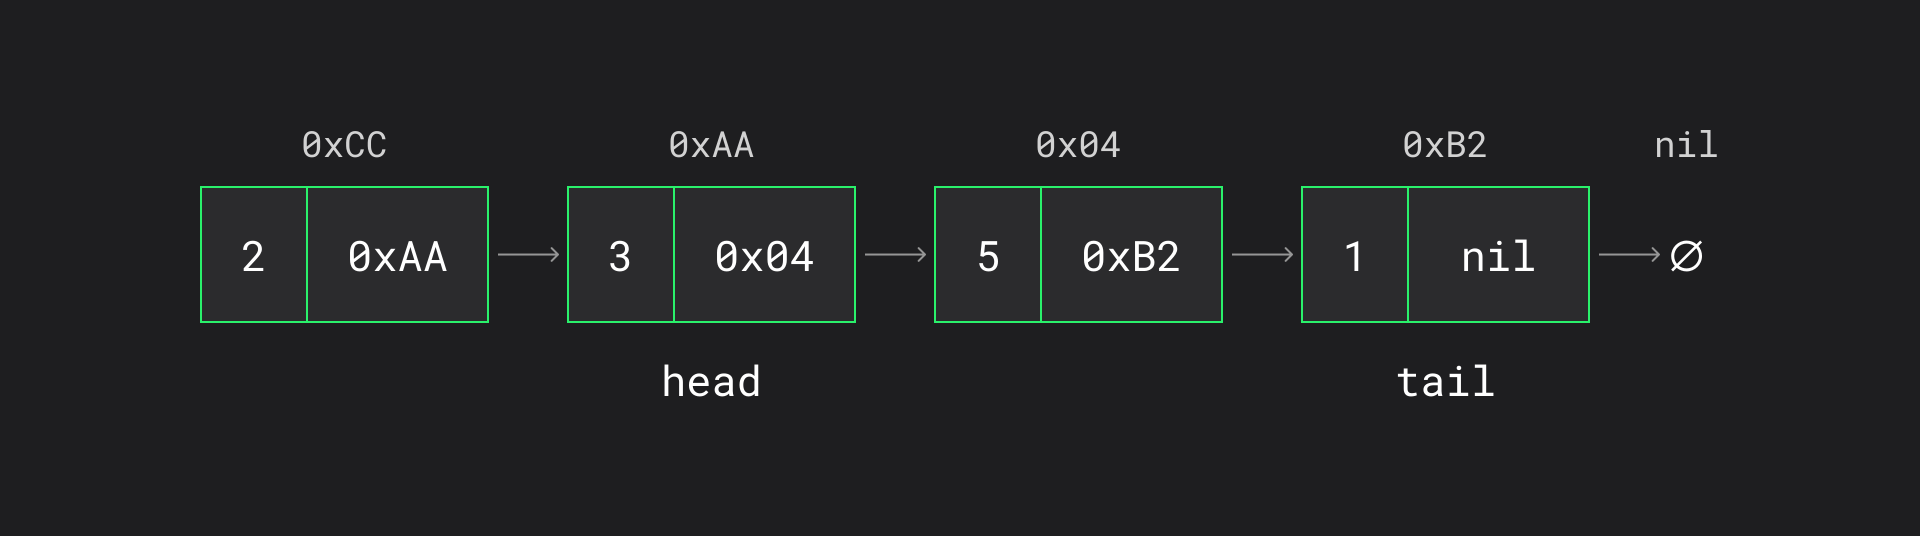
Указатель нового элемента направляется на текущую голову списка
Иными словами, поле next нового элемента начинает указывать на прежний первый элемент связного списка. Таким образом новый узел включается в существующую цепочку и становится ее предшествующим звеном.
Шаг 3. Обновление указателя head
После установления связи выполняется обновление указателя head.
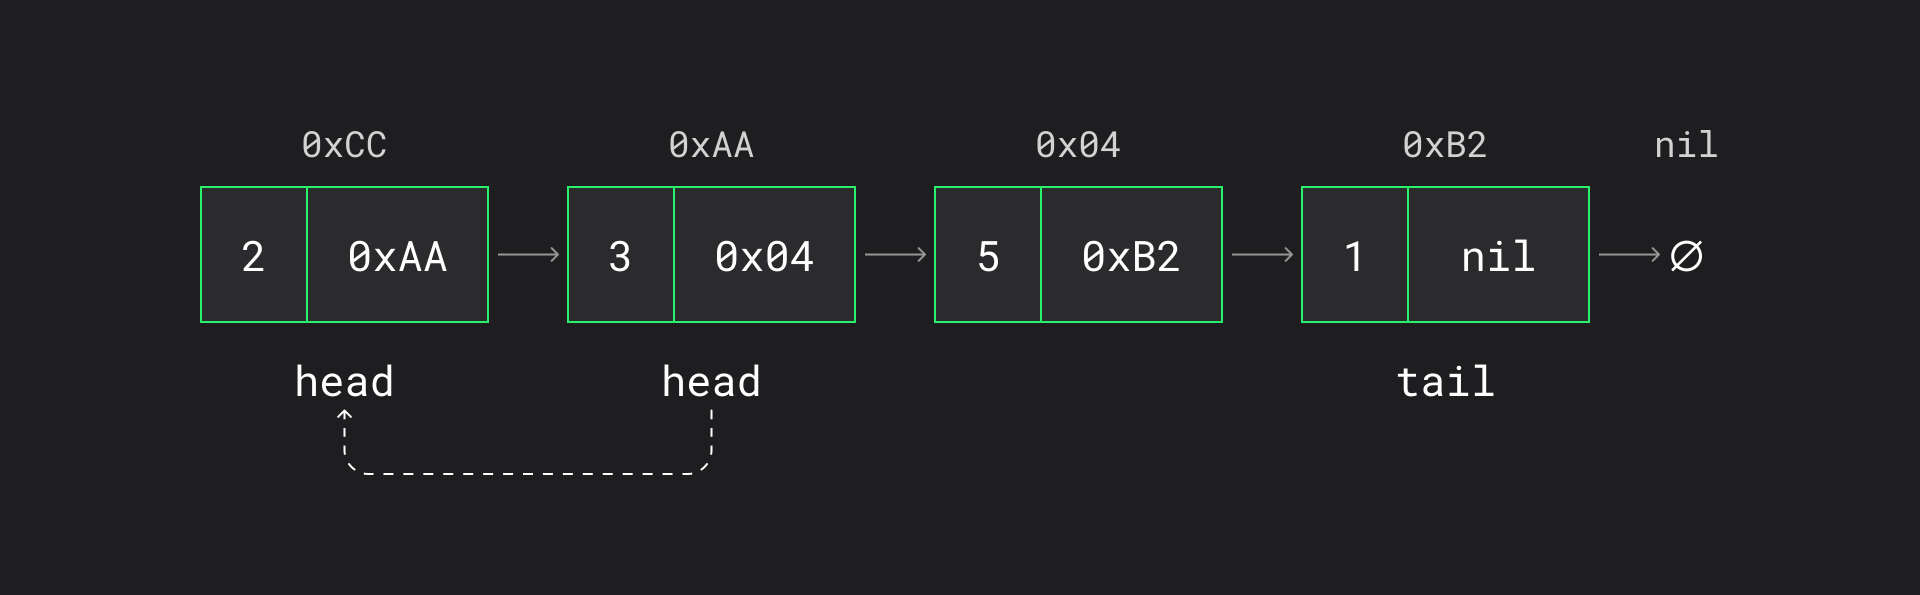
Переназначается указатель head
Указатель головы переназначается и ссылается на новый созданный элемент.
Предыдущий указатель head удаляется, а новый элемент становится первым в связном списке
В результате новый узел становится первым элементом связного списка, а прежняя голова становится вторым элементом структуры.
Операция никак не зависит от элементов связного списка, поэтому сложность как по времени, так и по памяти, — константная O(1).
Операция никак не зависит от элементов связного списка, поэтому сложность как по времени, так и по памяти, — константная O(1).
Вставка в конец связного списка
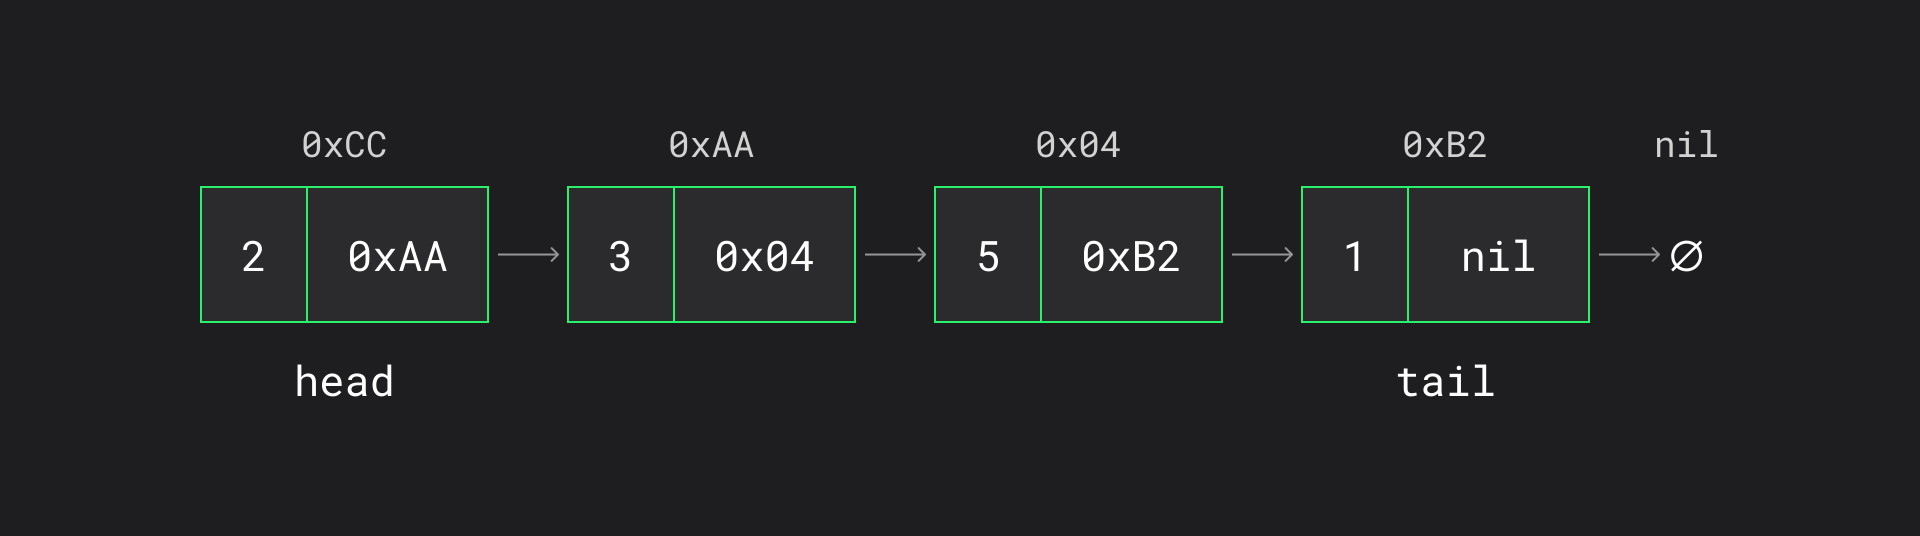
Рассмотрим операцию вставки нового элемента в конец списка. Операция включает три последовательных шага: создание нового узла, переназначение указателя next у предыдущего хвоста и обновление указателя tail.
Шаг 1. Создание нового узла
Создается новый узел (например, со значением = 7) и адресом памяти (например, 0x08).
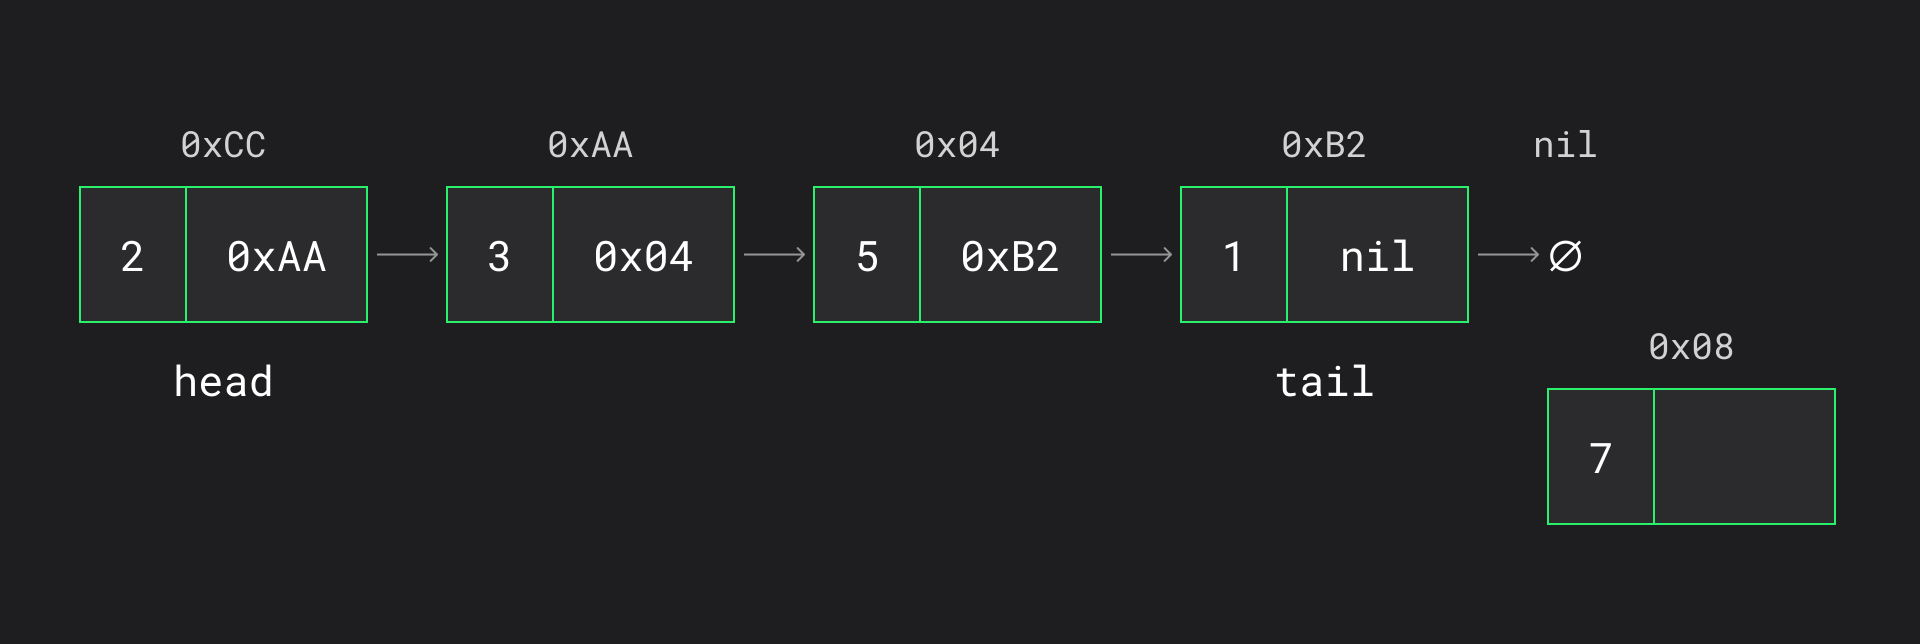
Создается новый элемент со значением «7» и адресом памяти 0x08
На момент создания его указатель не ссылается на элементы списка. Так как элемент является последним в структуре, его указатель next принимает значение nil.
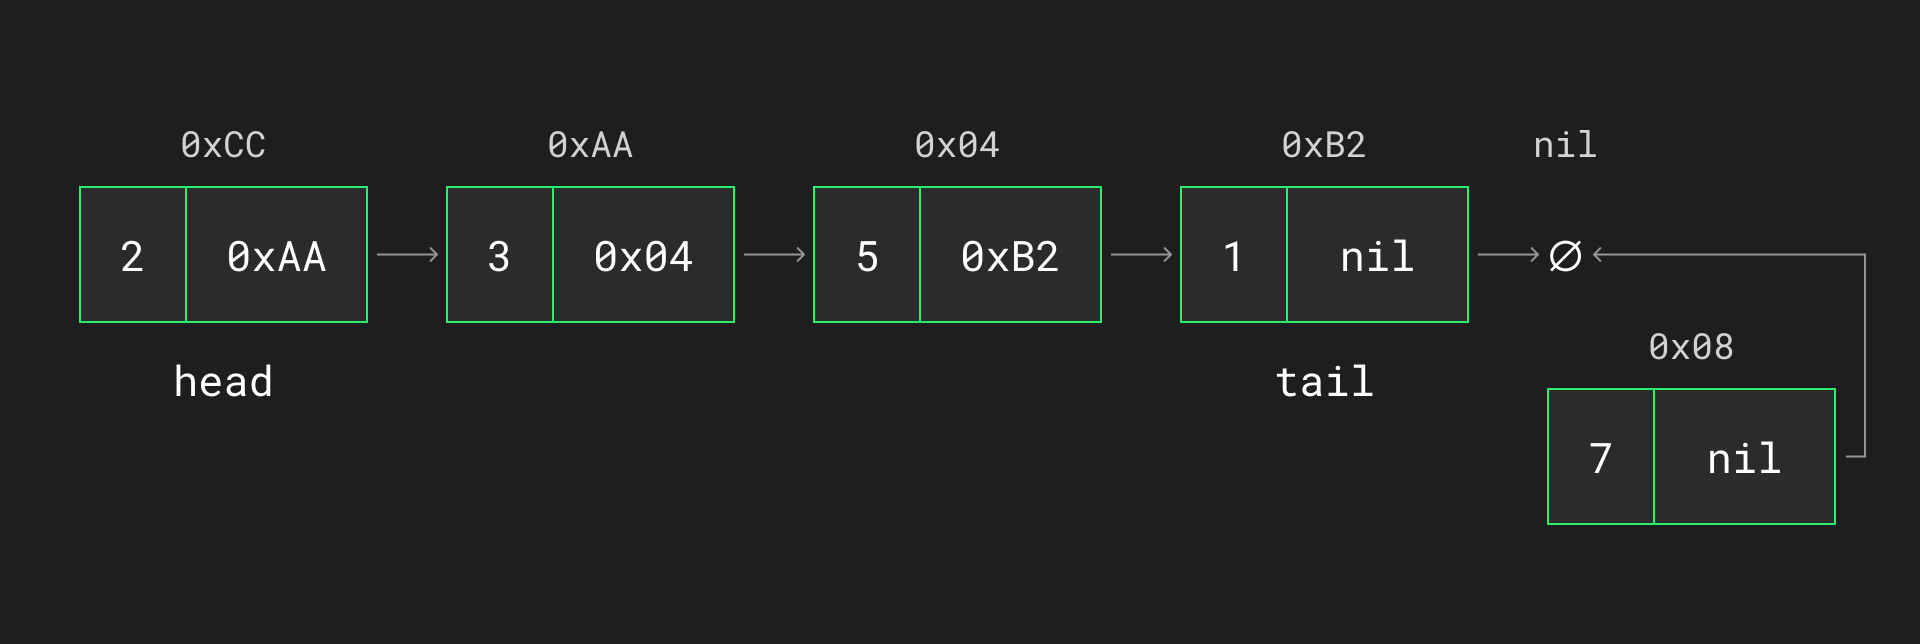
Указатель нового элемента как последнего указывает на nil
Шаг 2. Модификация последнего элемента
Далее выполняется операция связывания структуры: текущий последний элемент связного списка изменяет свой указатель таким образом, чтобы он ссылался на вновь созданный узел.
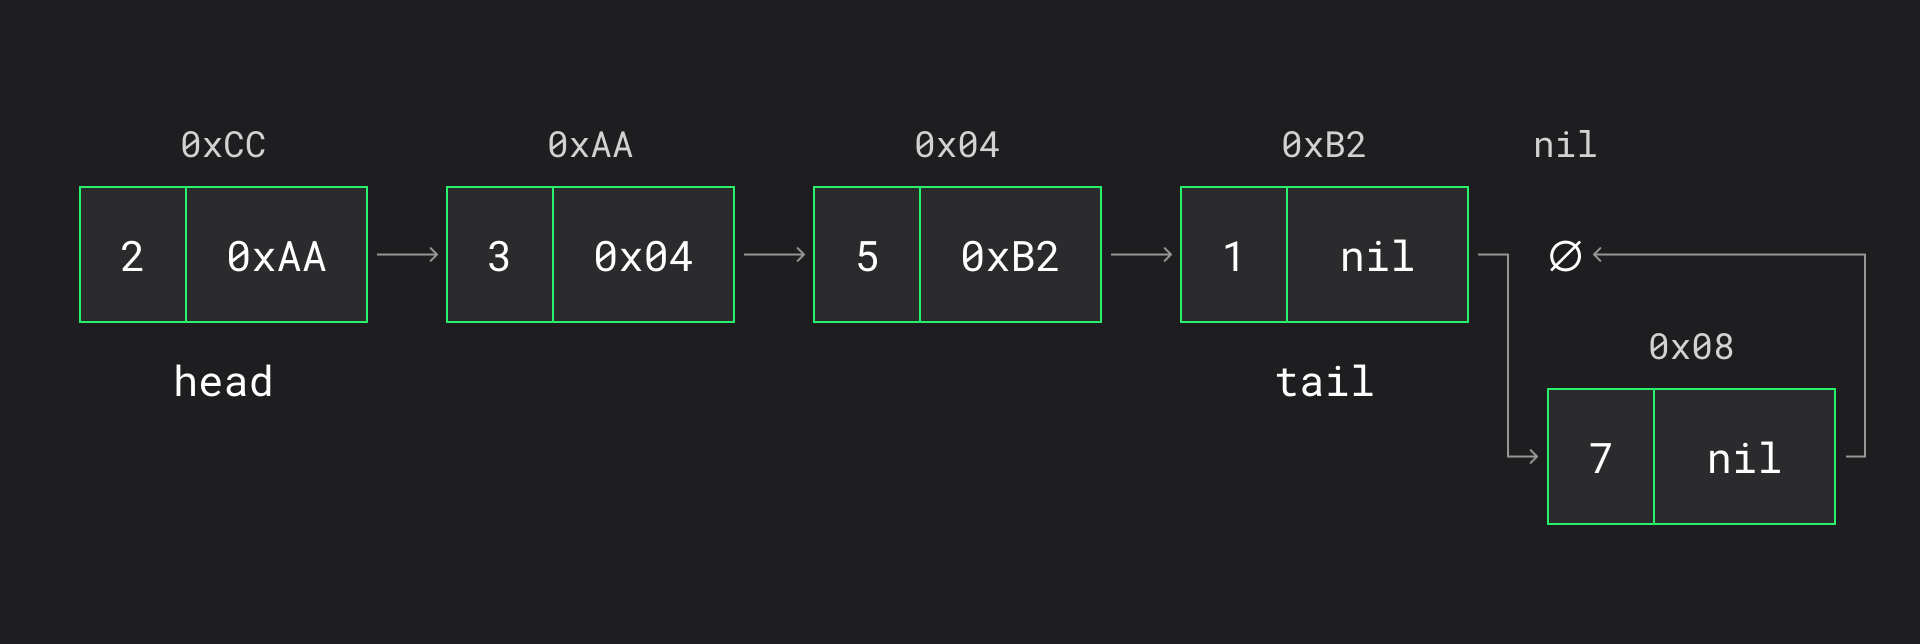
Текущий последний элемент ссылается на созданный узел. Прежняя связь удаляется, а прежний tail списка перестает указывать на nil
Таким образом, прежний хвост списка перестает указывать на nil и включается в цепочку связного списка, соединяясь с новым элементом.
Шаг 3. Обновление указателя tail
После этого выполняется обновление указателя tail. Указатель хвоста переназначается на вновь добавленный узел, который становится последним элементом структуры данных.
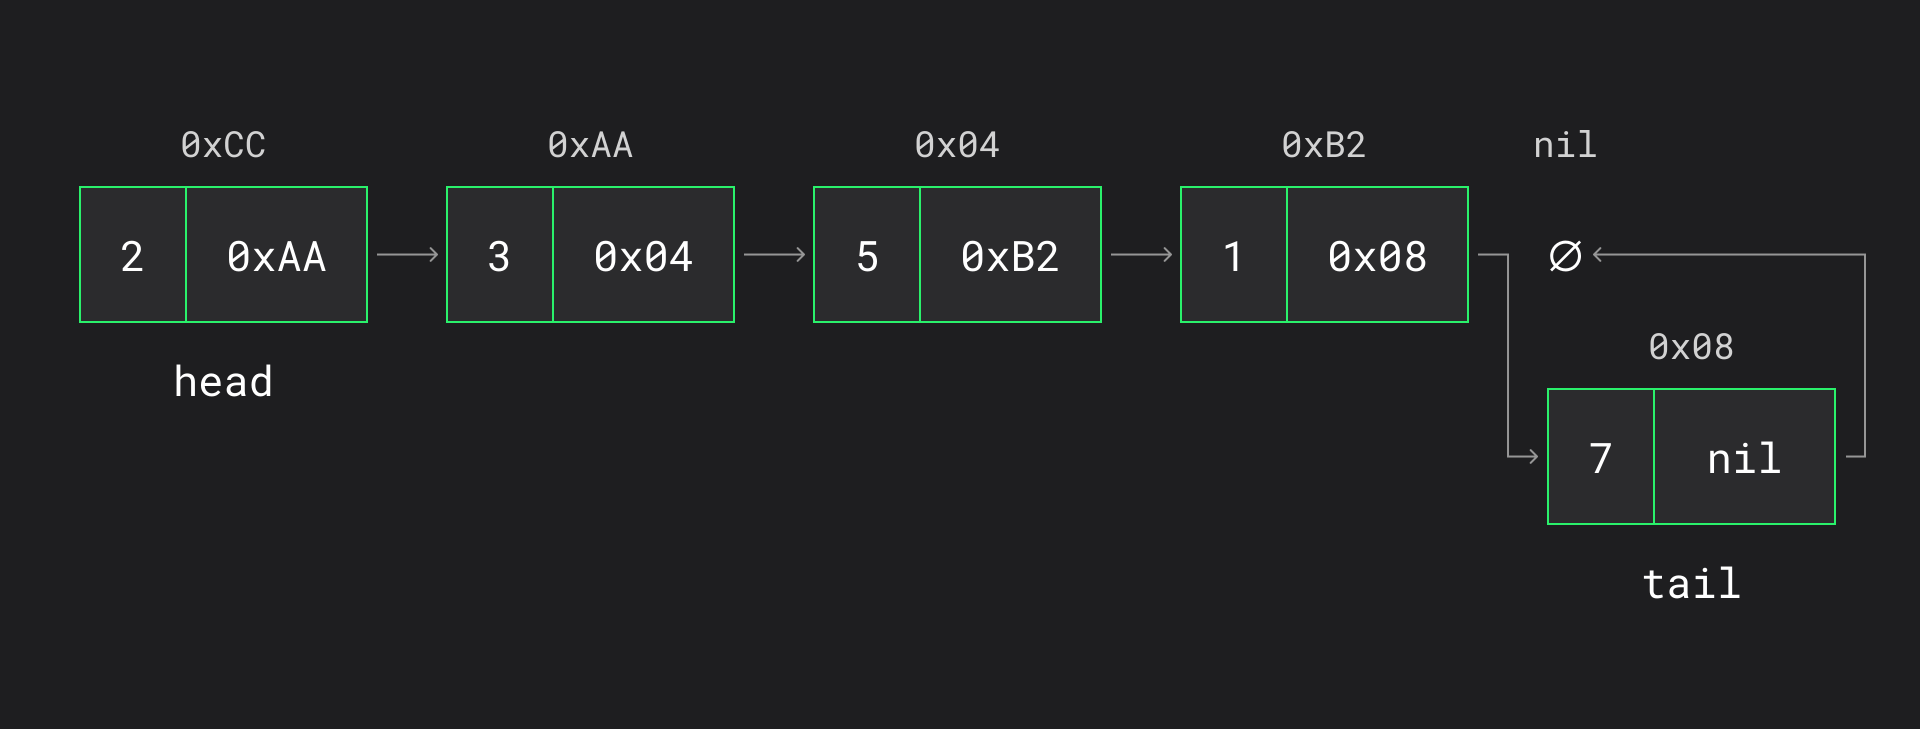
Указатель tail переназначается на новый элемент
Поскольку количество выполняемых операций не зависит от размера связного списка, временная и пространственная сложность данной операции является константной O(1).
Вставка в середину связного списка
Рассмотрим операцию вставки между двумя существующими узлами.
Шаг 1. Создание нового узла
Для вставки элемента в середину связного списка сначала выполняется создание нового узла. Присваиваем элементу значение (например, 8) и размещаем по некоторому адресу памяти (например, 0xB8).
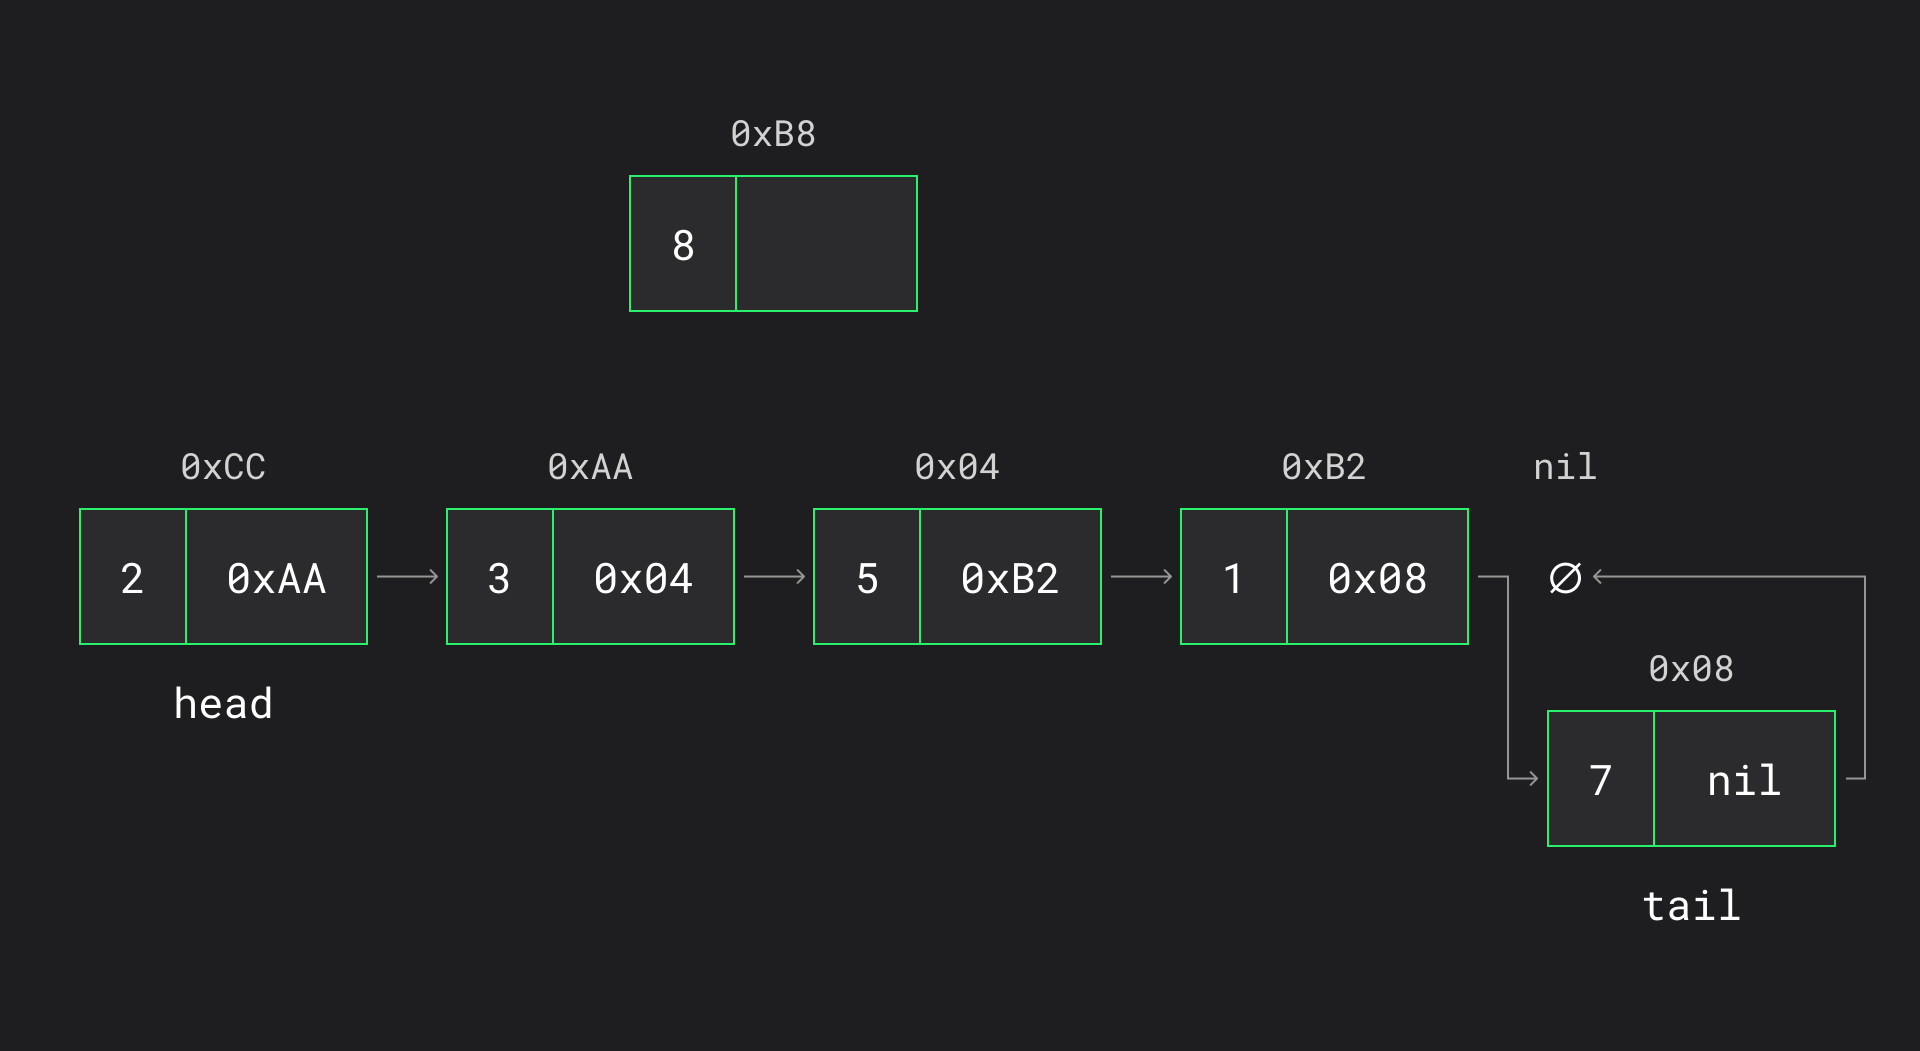
Создается новый элемент со значением «8» и адресом памяти 0xB8
На момент создания он не содержит корректных ссылок на элементы связного списка.
Шаг 2. Поиск и модификация позиции вставки
Представим, что у нас есть указатели на два элемента в связном списке. Для этого предполагается наличие двух указателей (или итераторов), которые указывают на два соседних элемента связного списка, между которыми должна быть выполнена вставка нового узла.
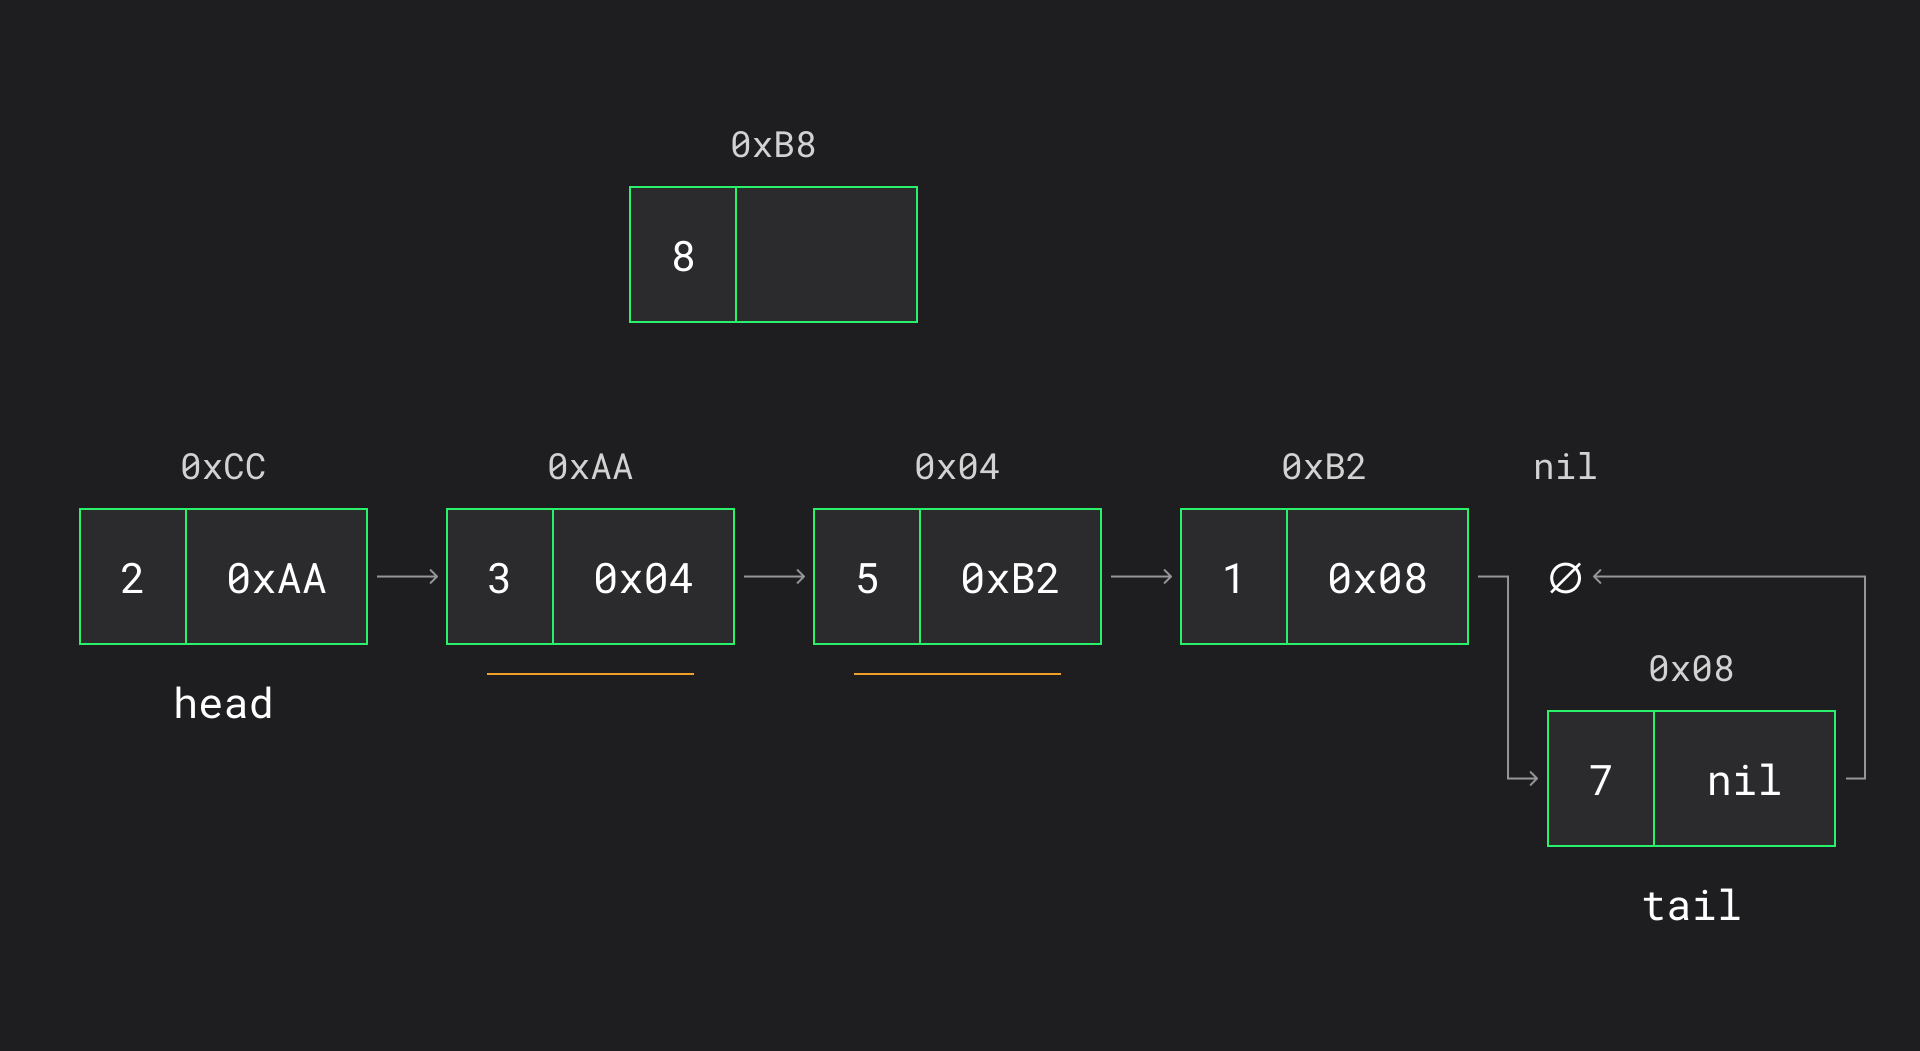
Определяется пара элементов и итераторов, между которыми будет вставлен новый узел
1. На первом этапе выполняется перенаправление указателя нового узла: указатель нового элемента теперь ссылается на правый элемент из пары.
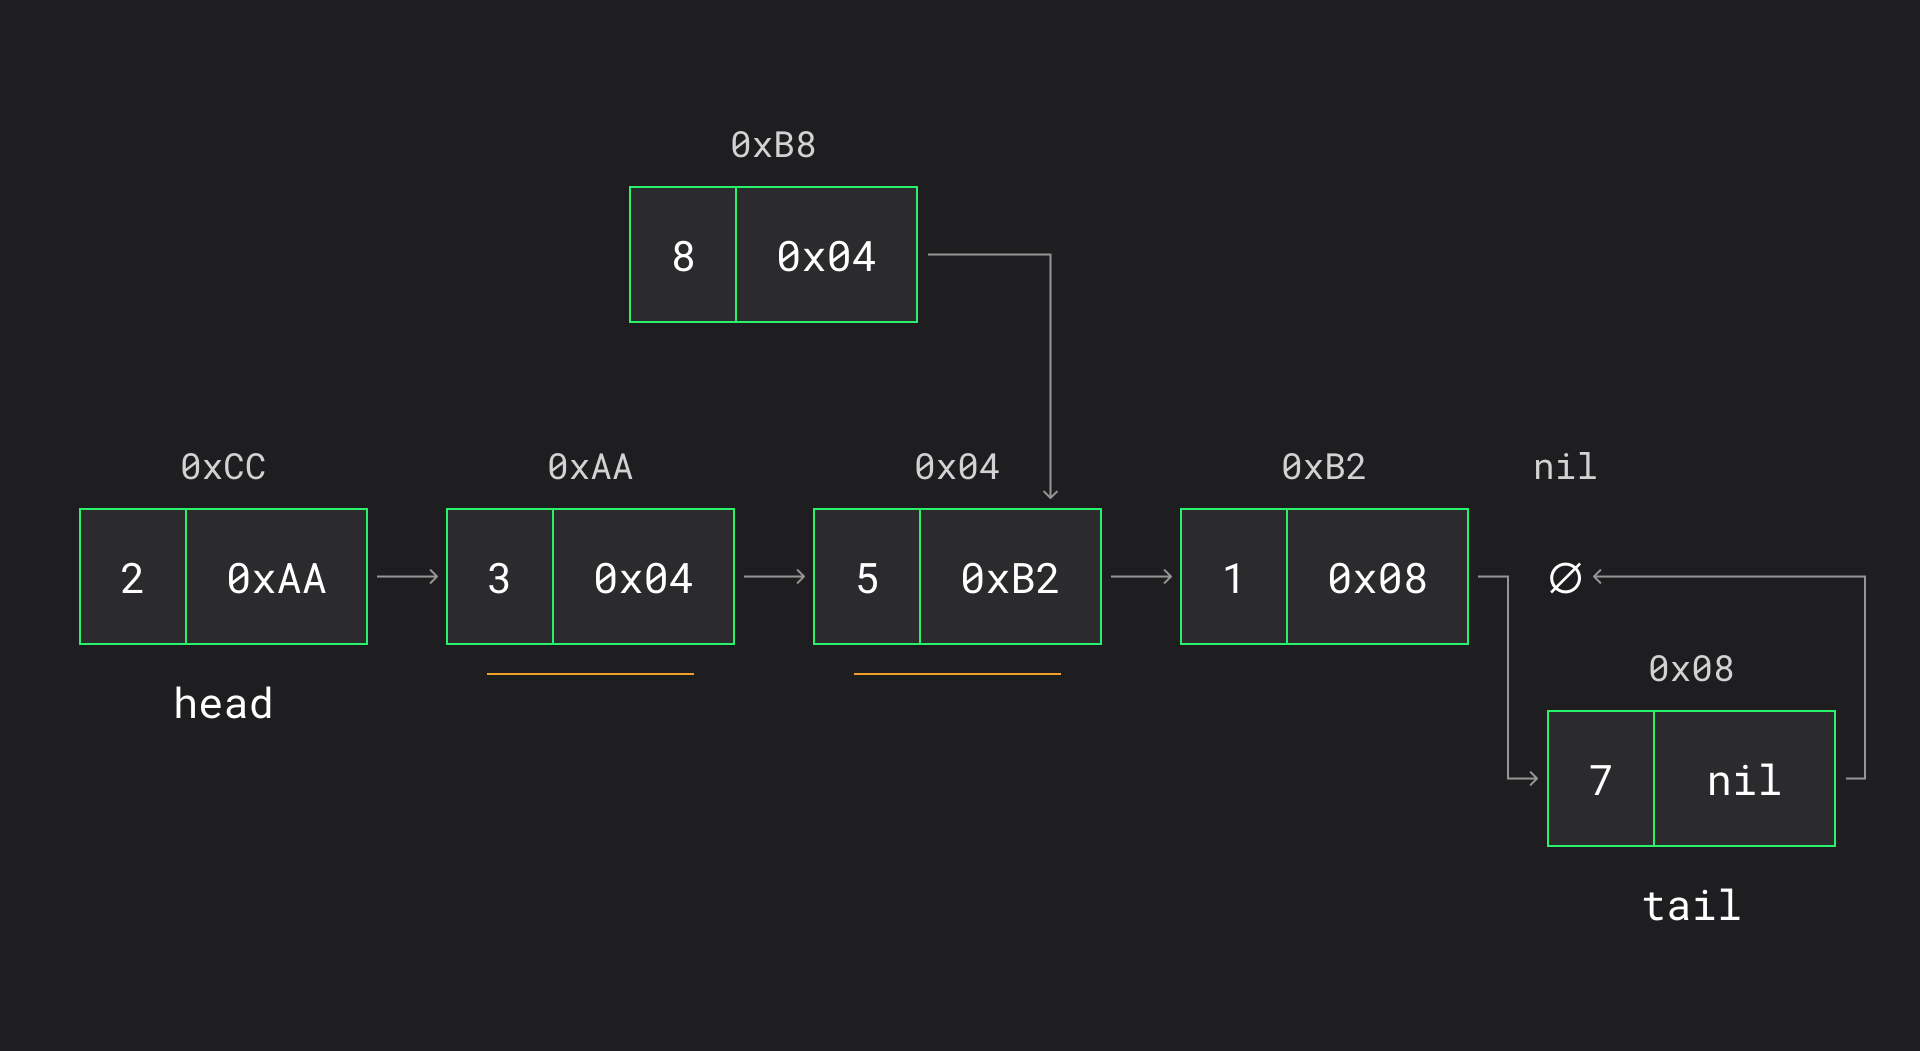
Новый элемент начинает указывать на последующий элемент связного списка.
2. На втором этапе выполняется разрыв существующей связи между двумя исходными узлами и перенаправление указателя левого узла. Указатель левого элемента теперь ссылается на вновь созданный узел.
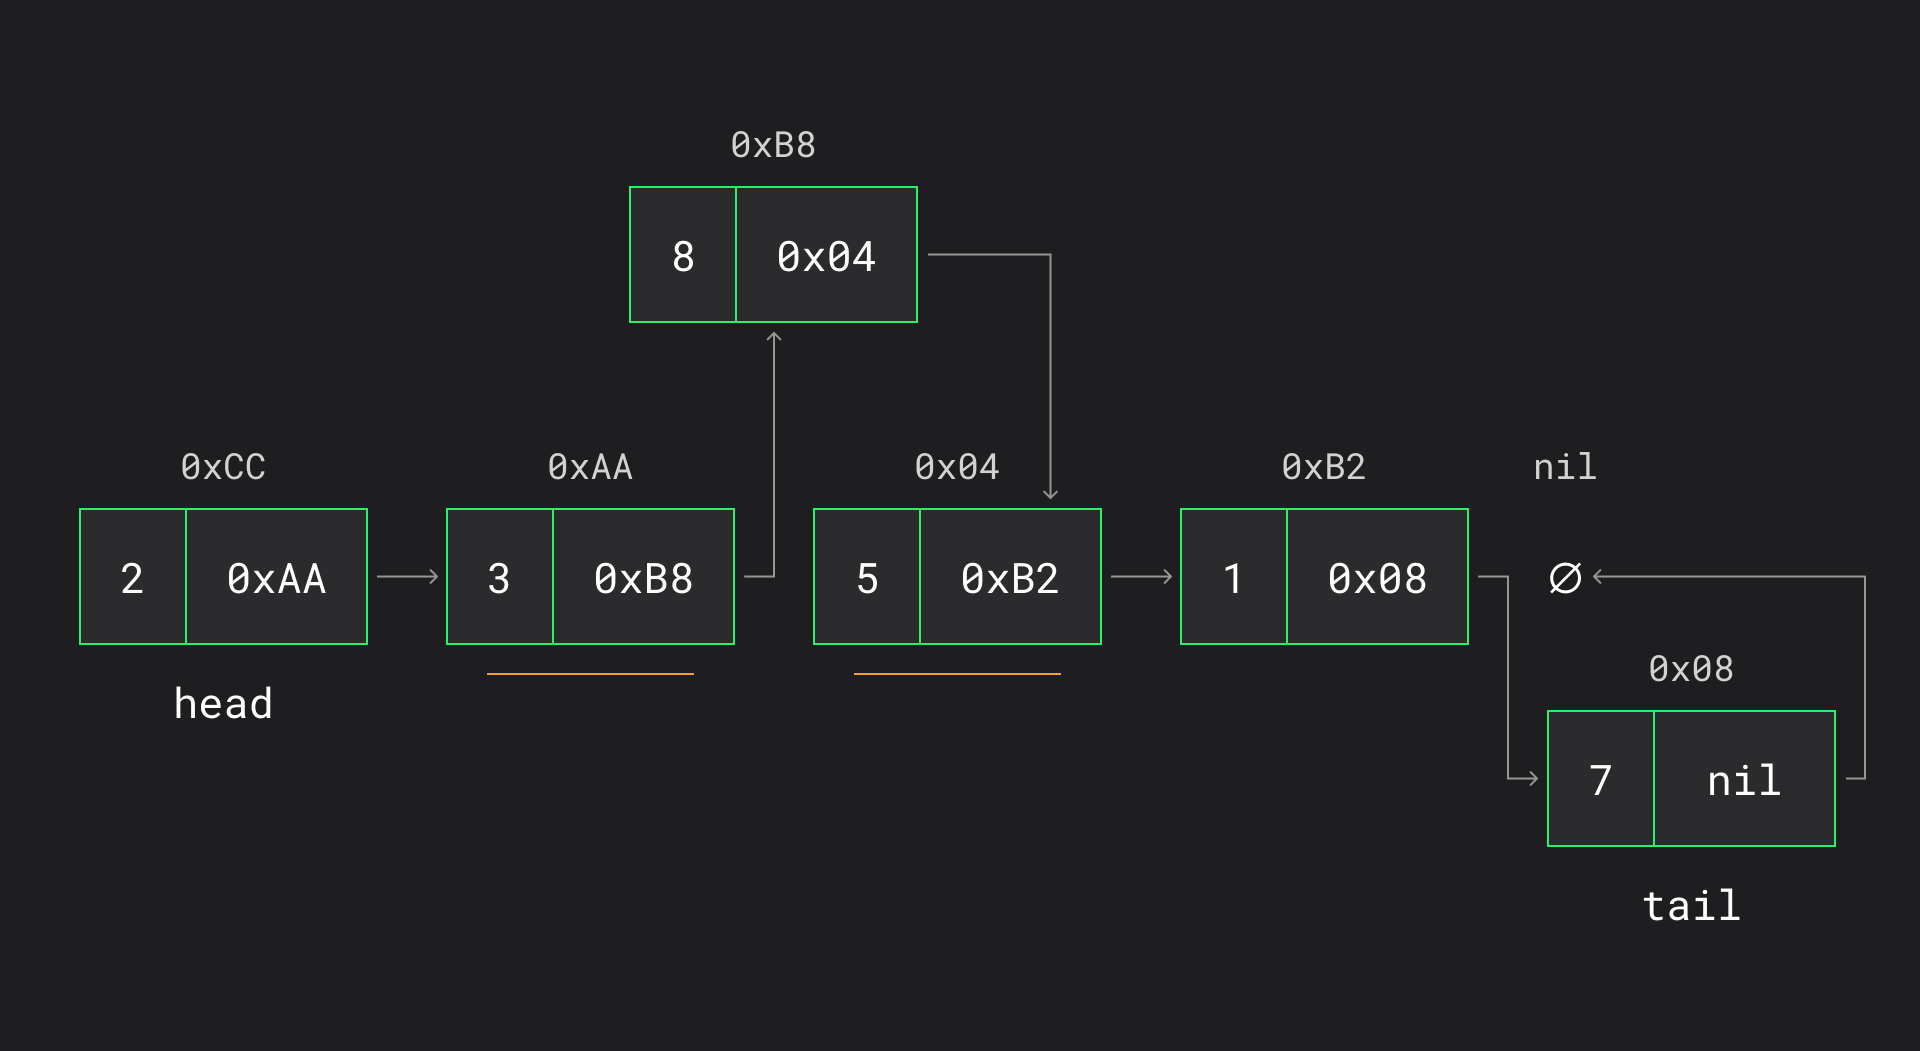
Новый элемент включается в структуру связного списка между двумя существующими узлами
Поскольку количество операций фиксировано и не зависит от размера связного списка, временная и пространственная сложность данной операции является константной O(1).
Это объясняется тем, что связный список представляет собой структуру данных с хаотичным размещением элементов в памяти. В отличие от массива, где элементы расположены последовательно и требуют сдвига при вставке, в связном списке физическое перемещение данных не требуется. Все операции сводятся исключительно к изменению ссылок между узлами
5. Удаление элемента
Удаление из начала списка
Рассмотрим операцию удаления первого элемента связного списка.
Шаг 1. Переназначение указателя head
В исходной структуре указатель head ссылается на первый узел списка. Для удаления данного узла достаточно выполнить переназначение указателя головы на следующий элемент.
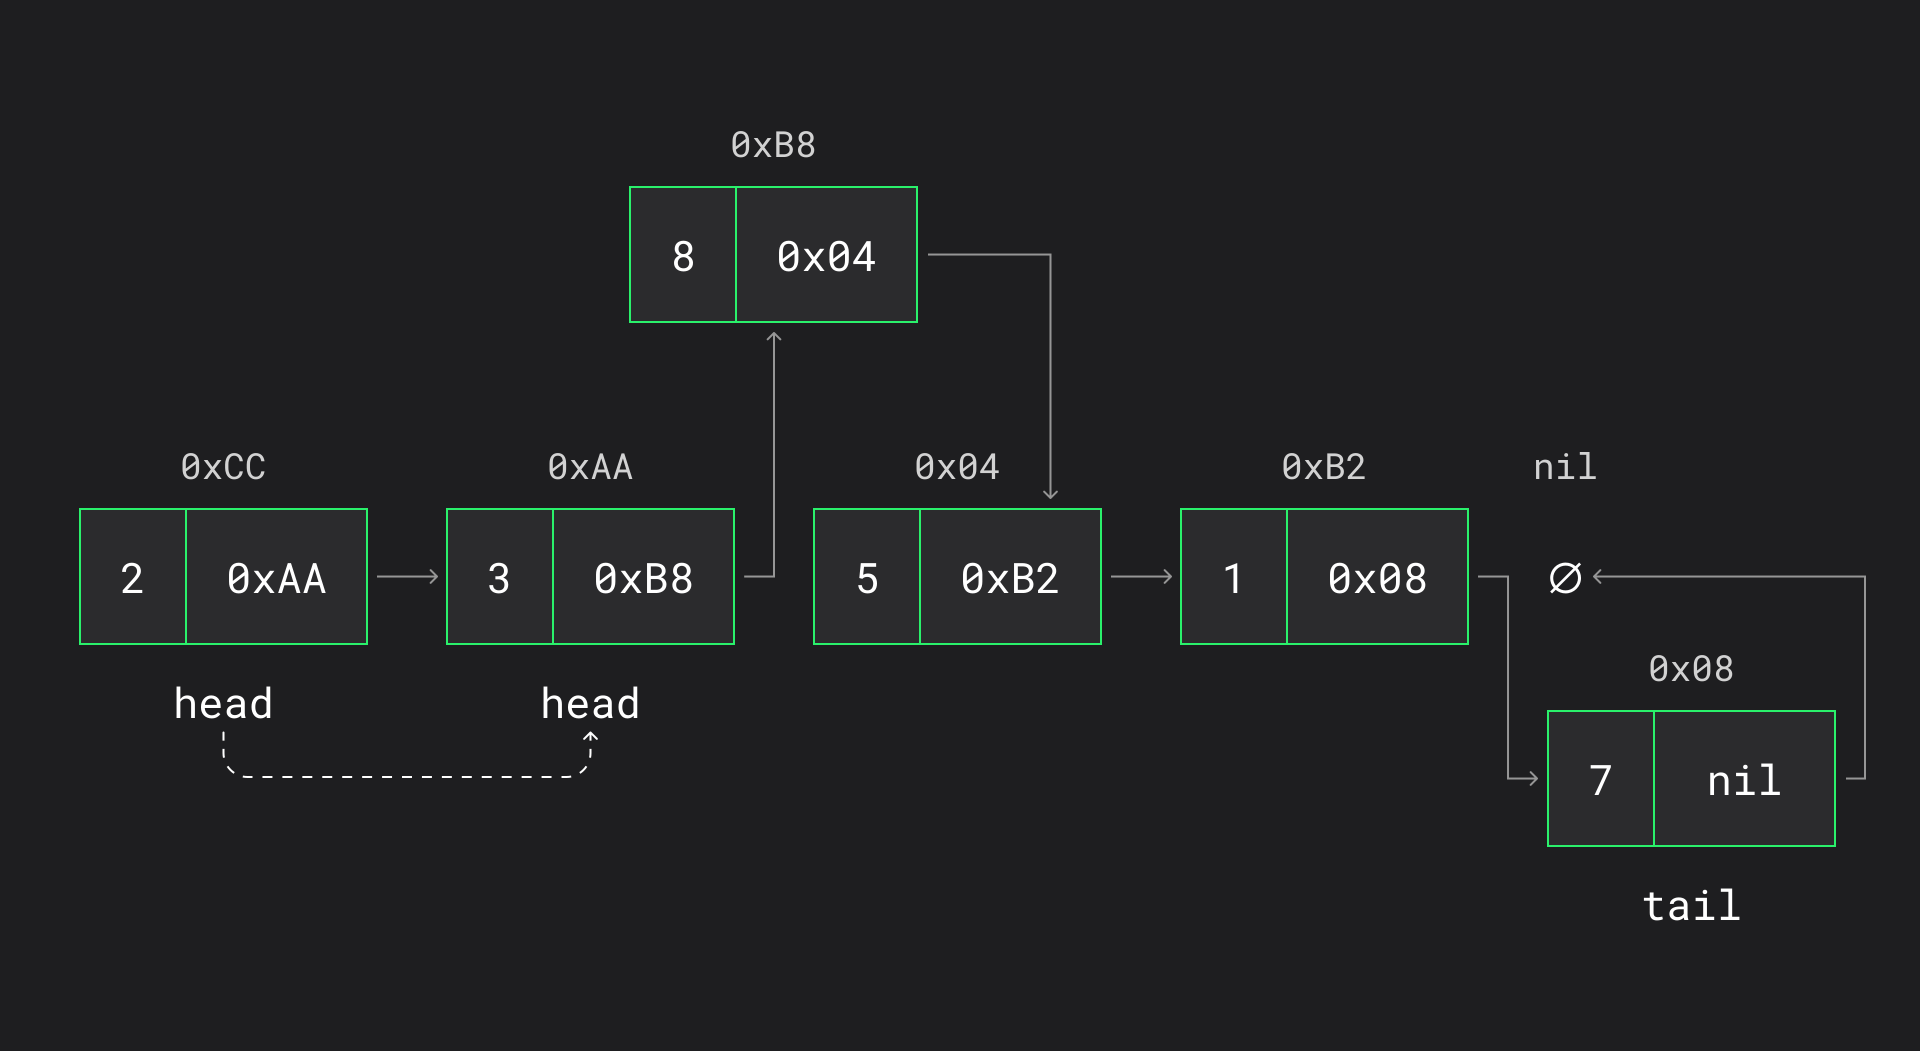
Указатель head передвигается на последующий элемент за текущей головой
После выполнения данной операции второй элемент списка становится новым первым элементом, а прежний первый элемент исключается из цепочки связей.
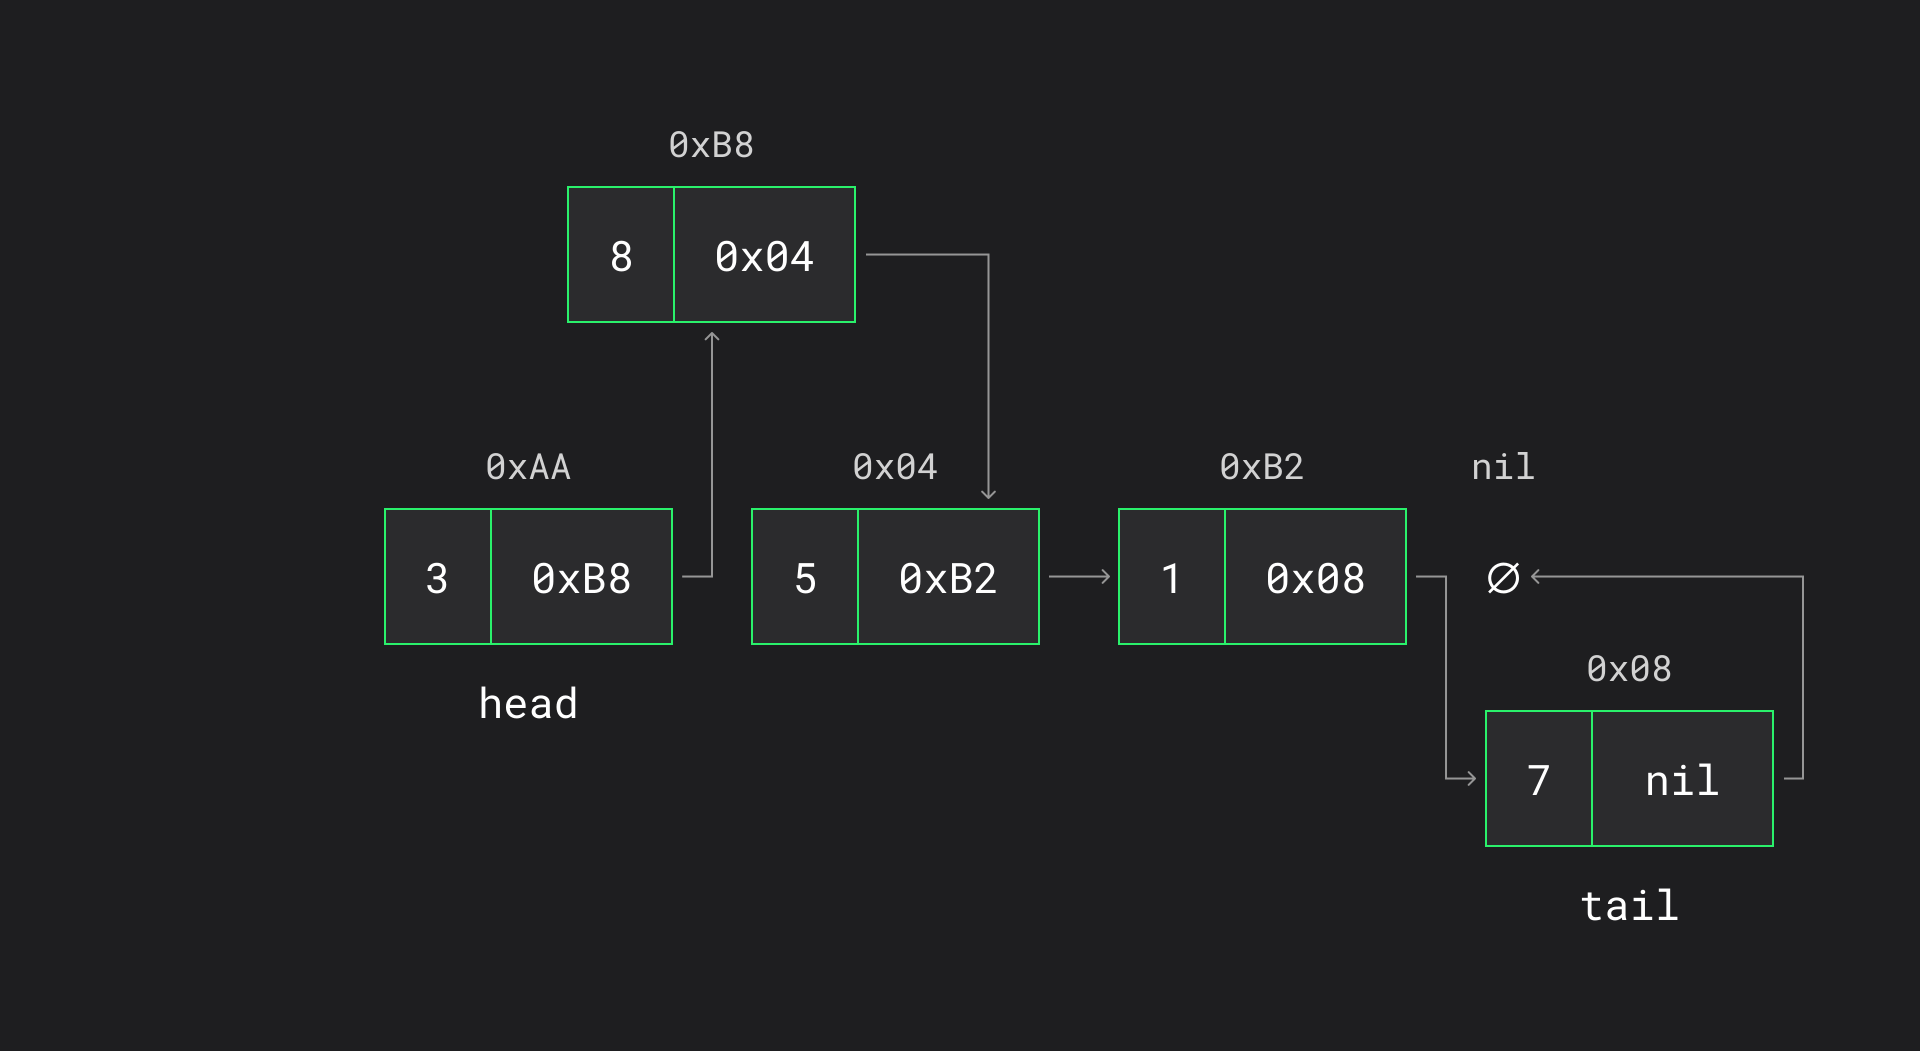
Второй элемент списка становится новой головой, а прежний первый — удаляется
Шаг 2. Освобождение памяти
После исключения элемента из структуры данных он становится недостижимым через указатели списка.
Дальнейшая обработка зависит от модели управления памятью:
Операция удаления из начала включает единственное изменение указателя head, следовательно, как по времени, так и по памяти — константная O(1).
Дальнейшая обработка зависит от модели управления памятью:
- при ручном управлении памятью вам нужно будет очистить выделенную память;
- при автоматическом управлении памятью сборщик мусора сам очистит этот участок памяти.
Операция удаления из начала включает единственное изменение указателя head, следовательно, как по времени, так и по памяти — константная O(1).
Удаление из конца списка
Удаление последнего элемента представляет собой более сложную задачу, так как односвязный список не содержит обратных ссылок.
Для того чтобы удалить последний элемент, нужно передвинуть tail на предыдущий узел.
Для того чтобы удалить последний элемент, нужно передвинуть tail на предыдущий узел.
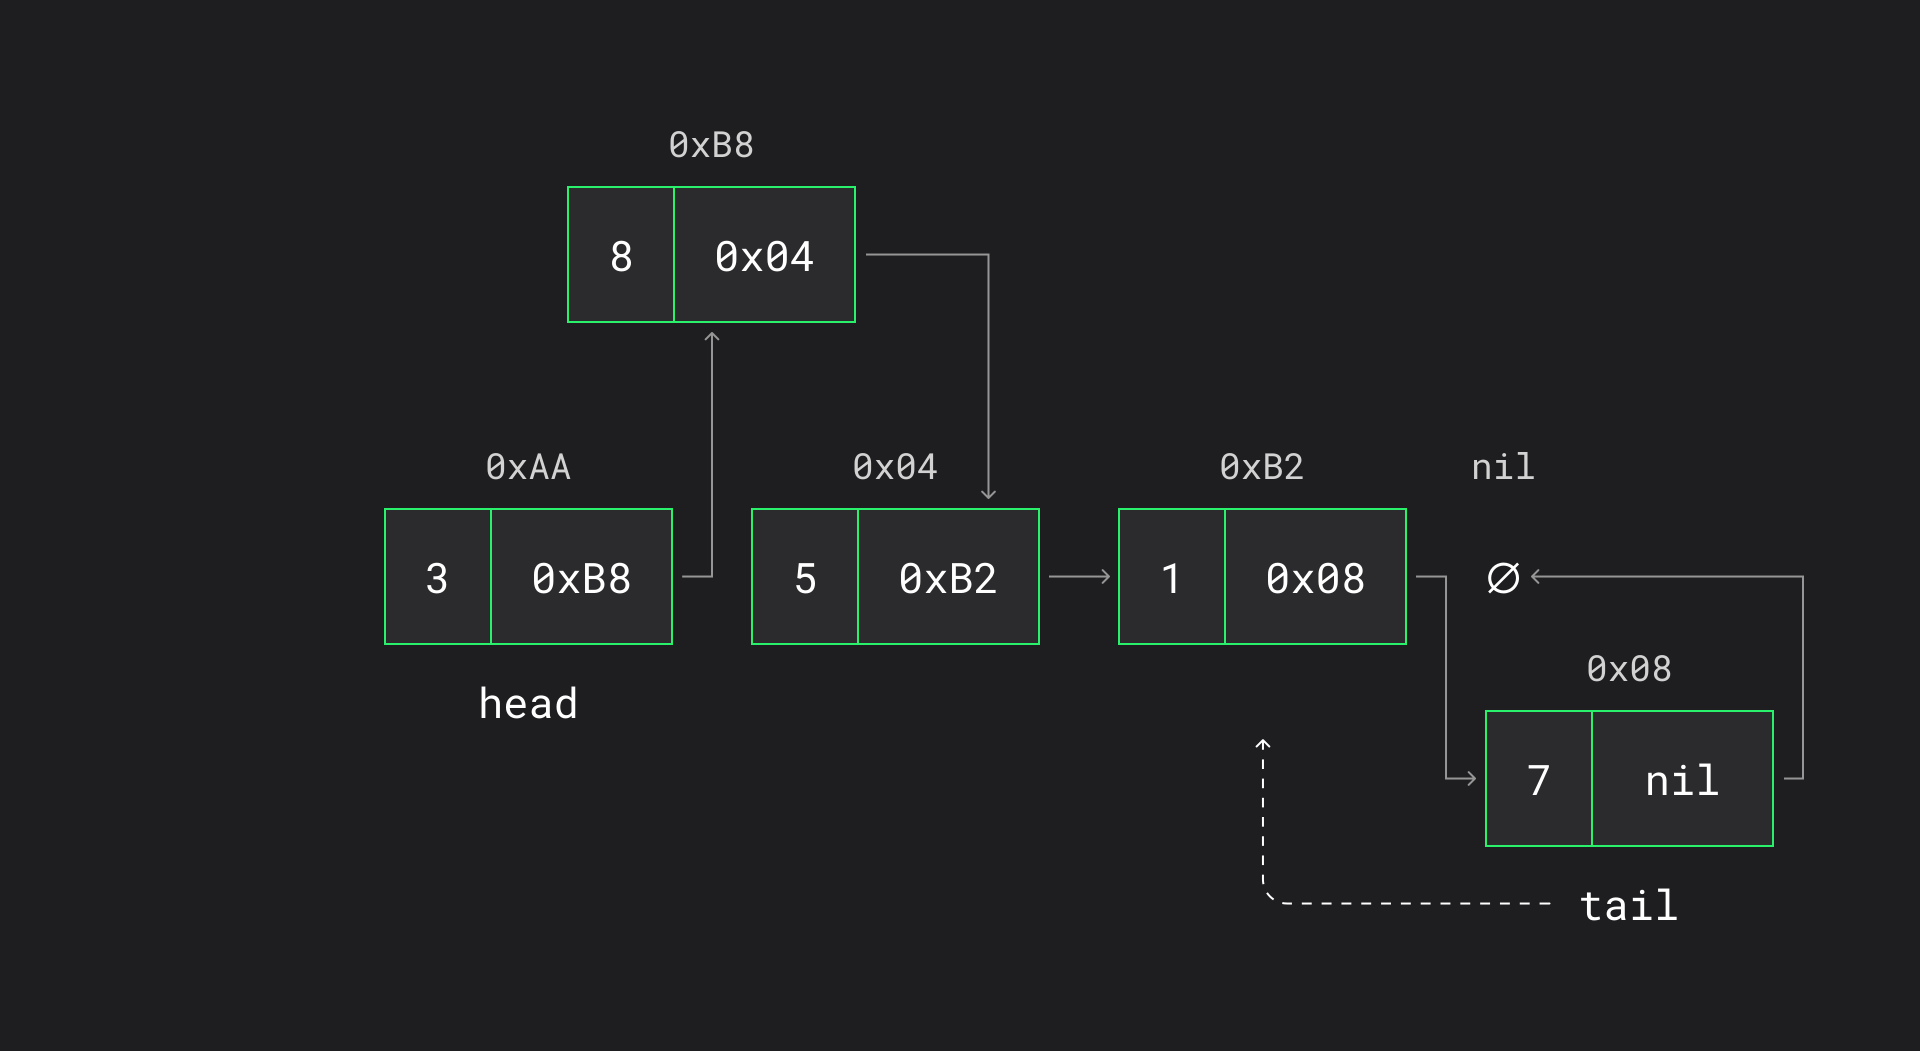
Для удаления последнего элемента tail сдвигается на предпоследний элемент
Но в классическом односвязном списке каждый элемент содержит ссылку только на следующий элемент, а не на предыдущий. Это означает отсутствие прямого доступа к предыдущему элементу, что затрудняет удаление последнего элемента.
Шаг 1. Поиск предпоследнего элемента перед хвостом
Через какие стратегии можно определить предыдущий элемент от хвоста:
- Полный проход спискаНеобходимо начать с головы и пройти весь список до предпоследнего элемента. Подобный перебор займет много времени
- Использование двусвязного спискаВ структуру добавляется обратный указатель prev, позволяющий переходить к предыдущему элементу напрямую от хвоста связного списка. Более подробно про двусвязные списки читайте в конце статьи
- Хранение дополнительной информацииМожно хранить ссылку на предпоследний элемент вместе с хвостом и обновлять ее при изменениях списка
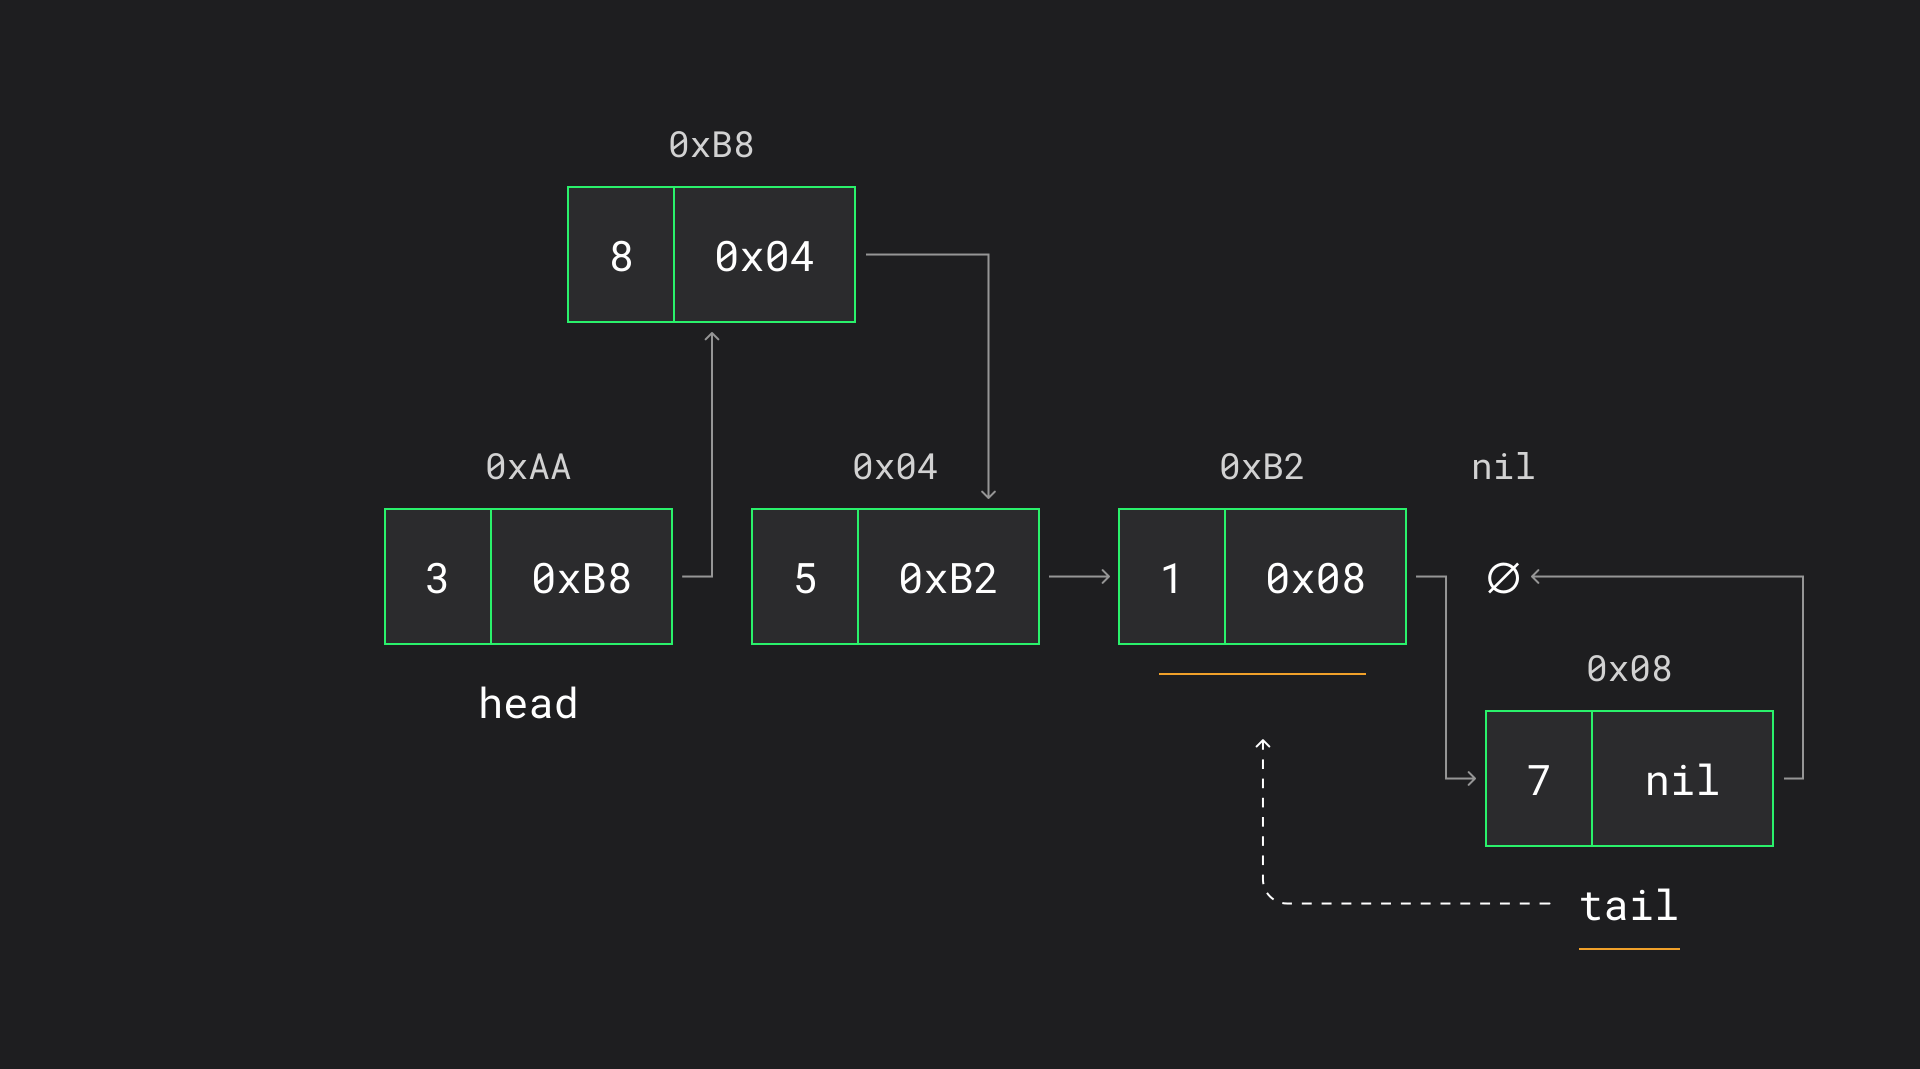
В памяти хранится ссылка на хвост списка и предыдущий его элемент (хранение обозначено подчеркиванием)
Шаг 2. Обновление хвоста
После определения предпоследнего элемента меняем положение tail на предыдущий от хвоста элемент.
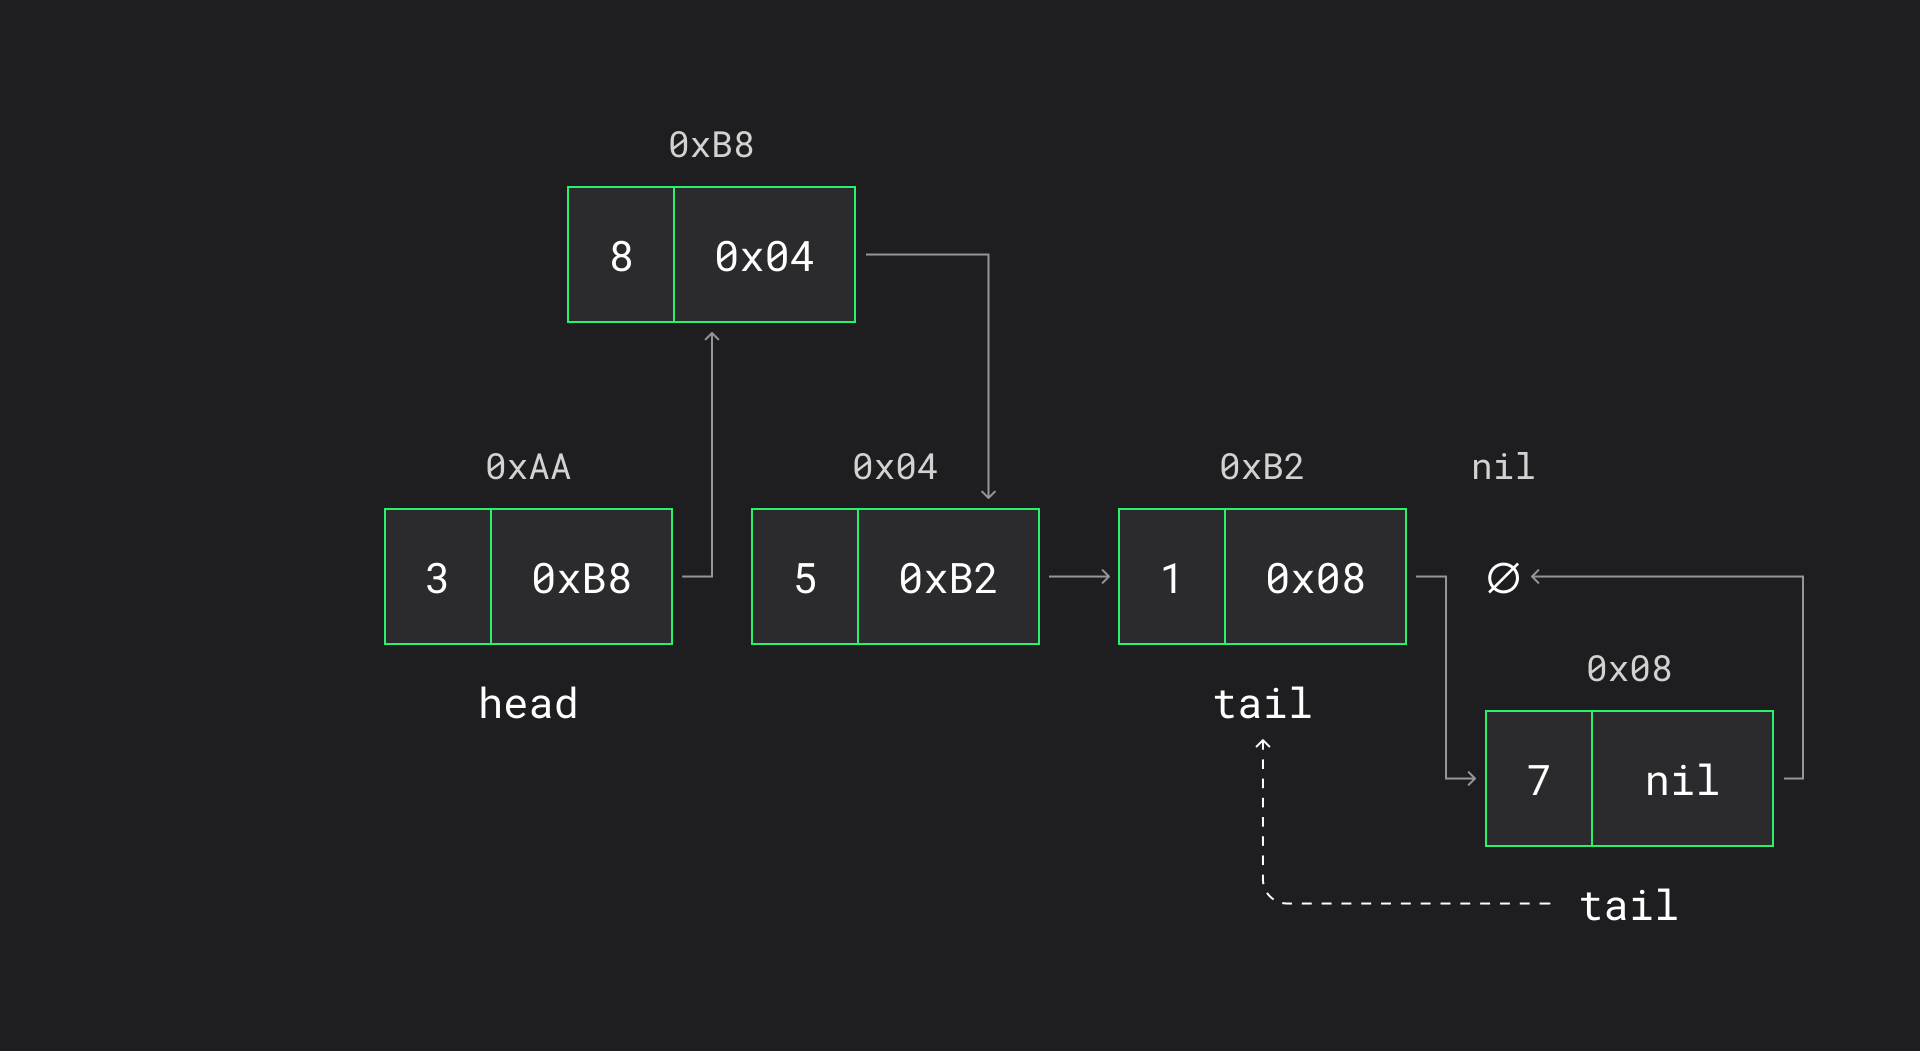
Tail теперь указывает на предыдущий от конца элемент
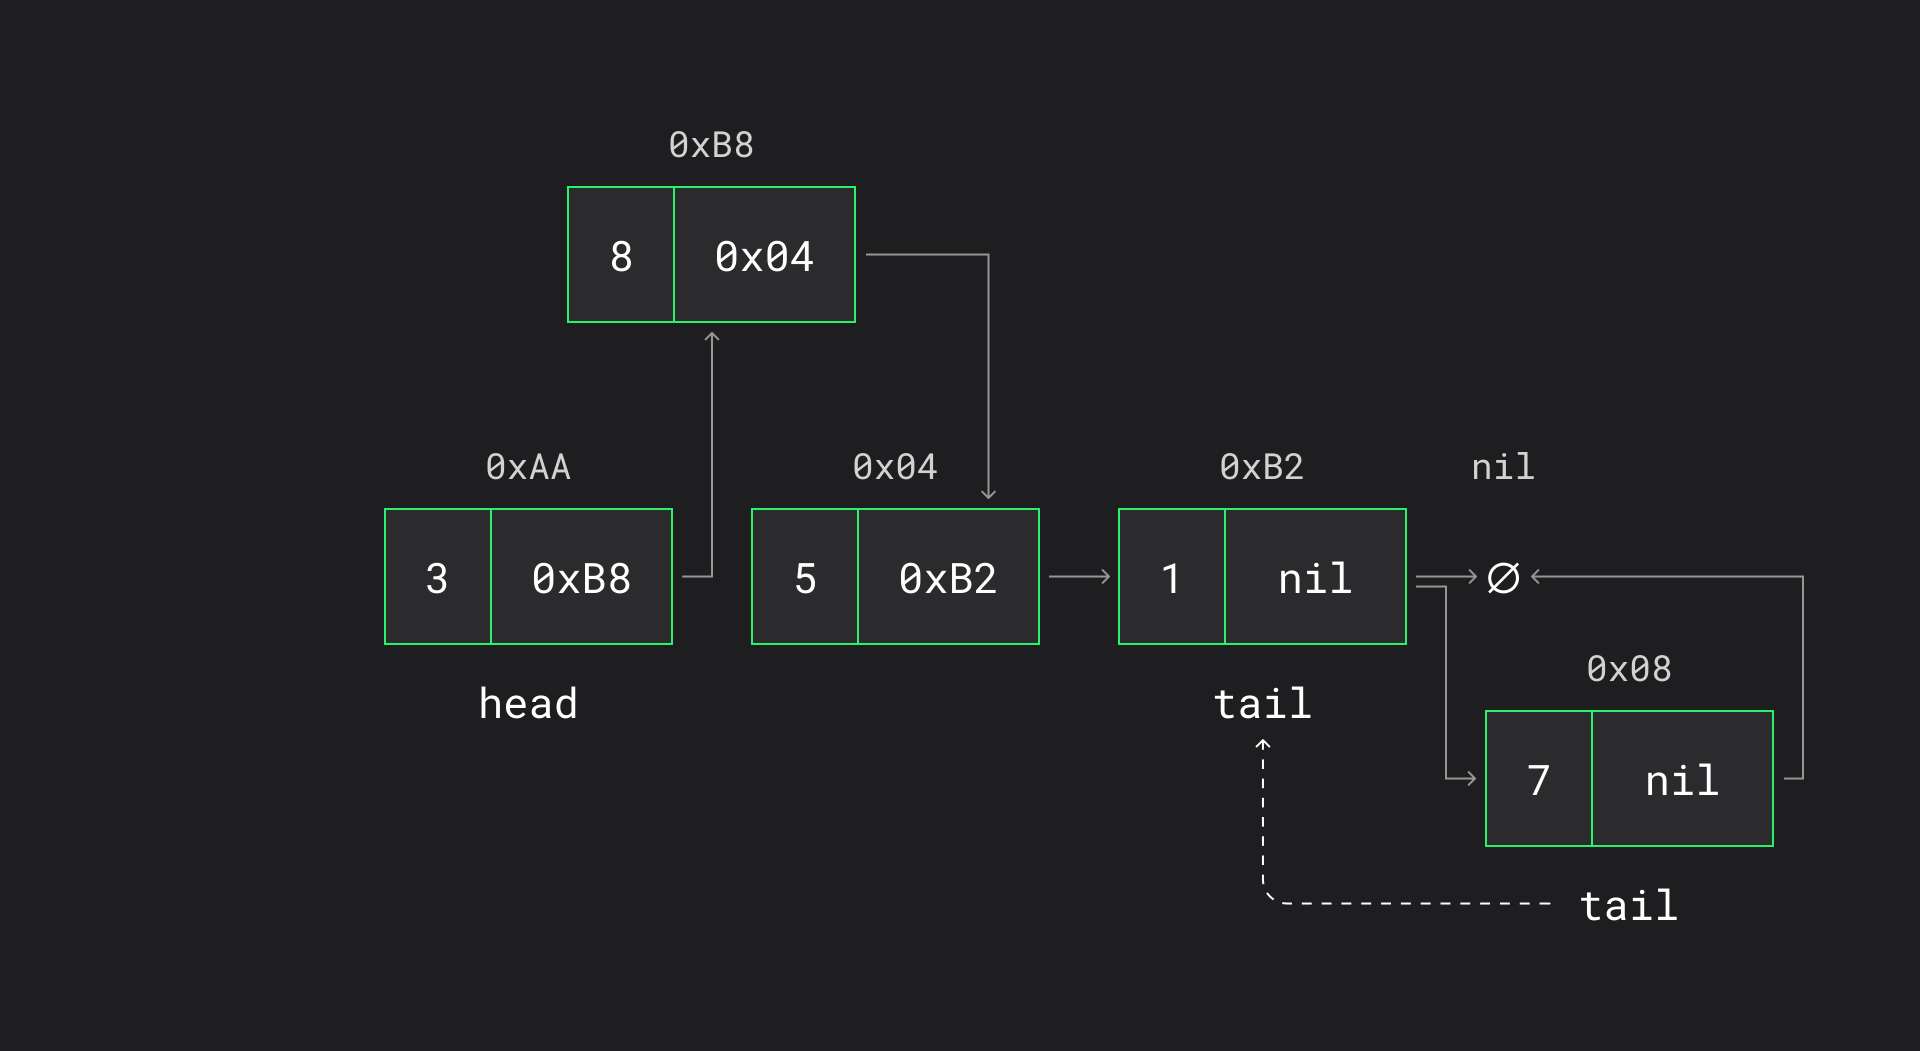
Указатель обновляется на nil после обновления на новый хвост
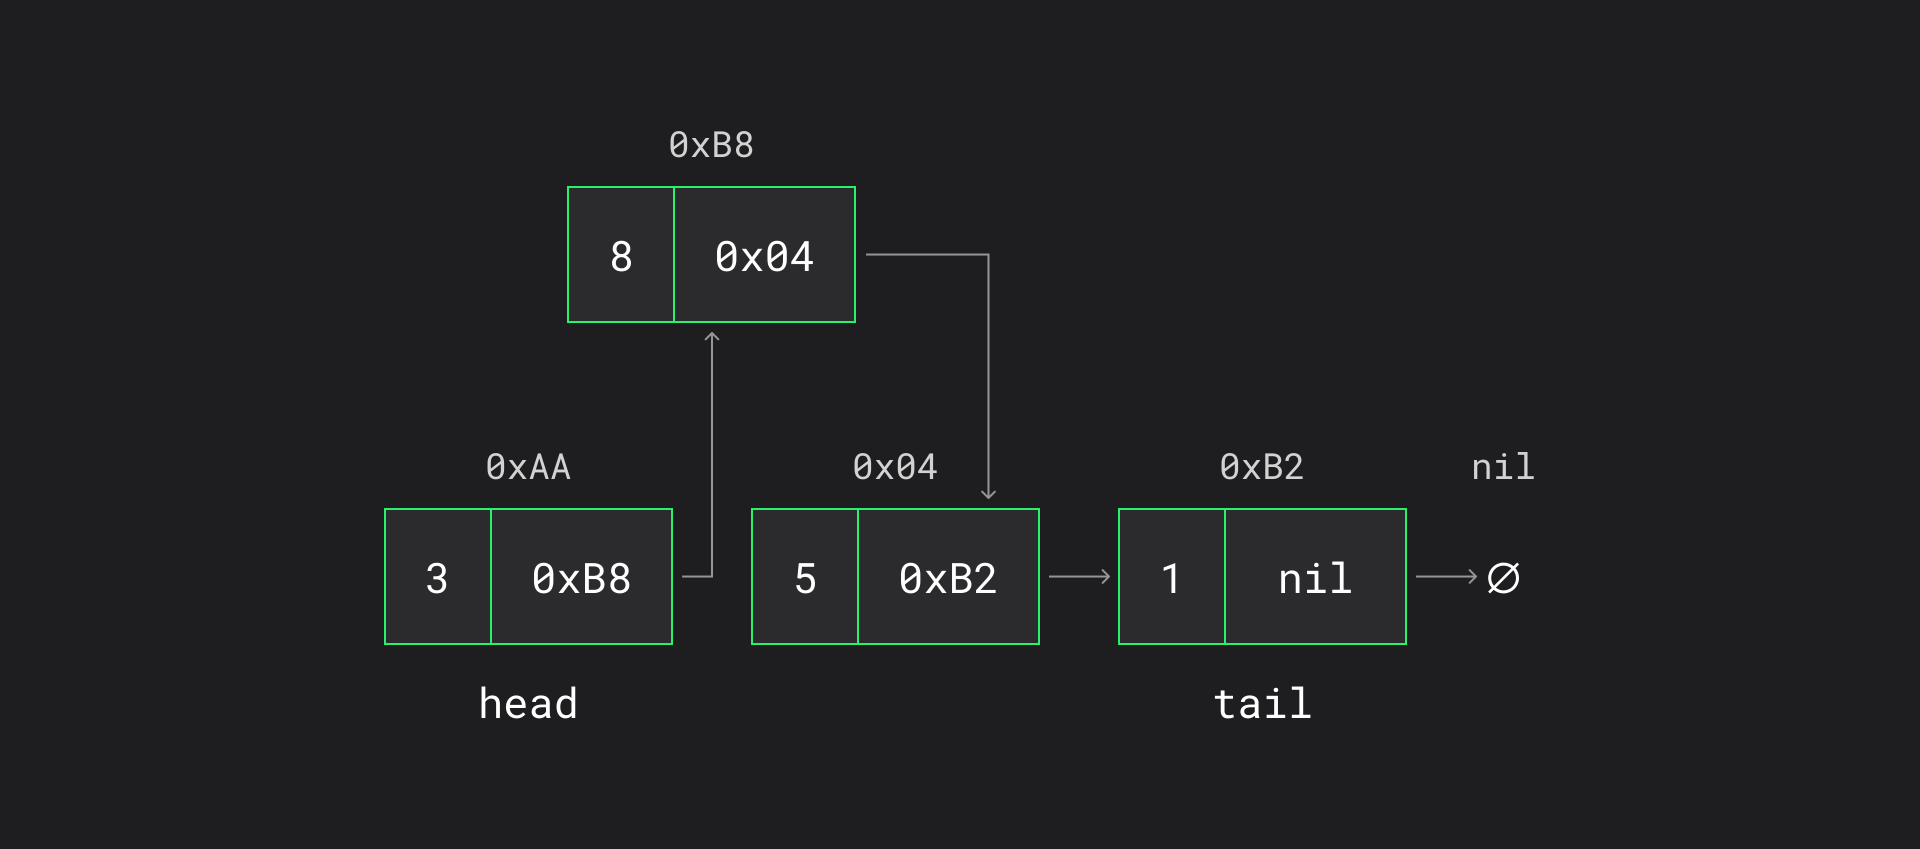
Предыдущий хвост удаляется и меняется указатель нового хвоста на nil
Тем самым последний элемент исключается из цепочки, а новый хвост корректно завершается.
Шаг 3. Освобождение памяти
Удаленный узел становится недоступным через структуру данных. В дальнейшем память от удаленного узла освободится вами вручную либо при автоматической очистке сборщиком мусора.
Если у вас изначально есть указатель на предыдущий элемент, то сложность удаления из конца будет константной О(1) как по времени, так и по памяти, т. к. все, что нужно будет сделать — это передвинуть tail и у предыдущего элемента обновить следующий элемент.
Если у вас изначально есть указатель на предыдущий элемент, то сложность удаления из конца будет константной О(1) как по времени, так и по памяти, т. к. все, что нужно будет сделать — это передвинуть tail и у предыдущего элемента обновить следующий элемент.
Удаление из середины списка
Рассмотрим удаление произвольного элемента, доступ к которому уже известен.
Представим, что у нас снова есть указатель, и вы понимаете, какой элемент вы хотите удалить.
Представим, что у нас снова есть указатель, и вы понимаете, какой элемент вы хотите удалить.
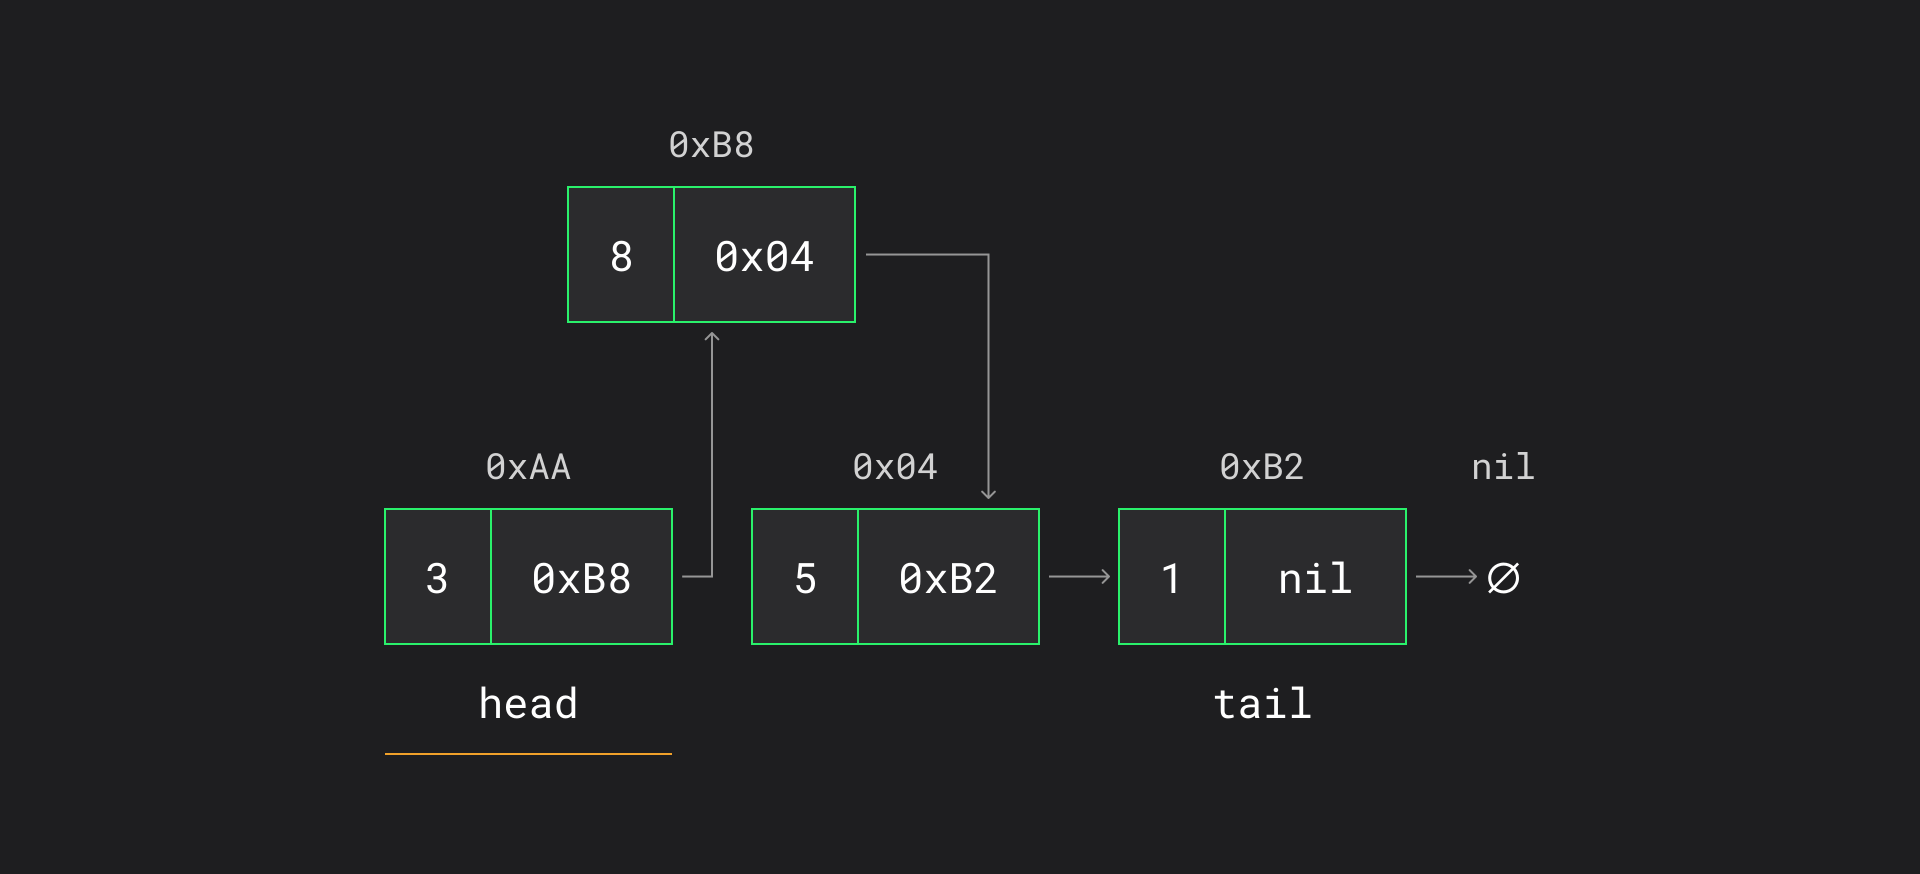
Планируется удалить элемент, который идет вслед за указателем
Для удаления все, что нужно сделать, — это обновить указатель, чтобы элемент со значением «3» начал указывать на элемент со значением «5».
Сперва смотрим, куда указывает элемент со значением «3» — на элемент со значением «8»
Сперва смотрим, куда указывает элемент со значением «3» — на элемент со значением «8»
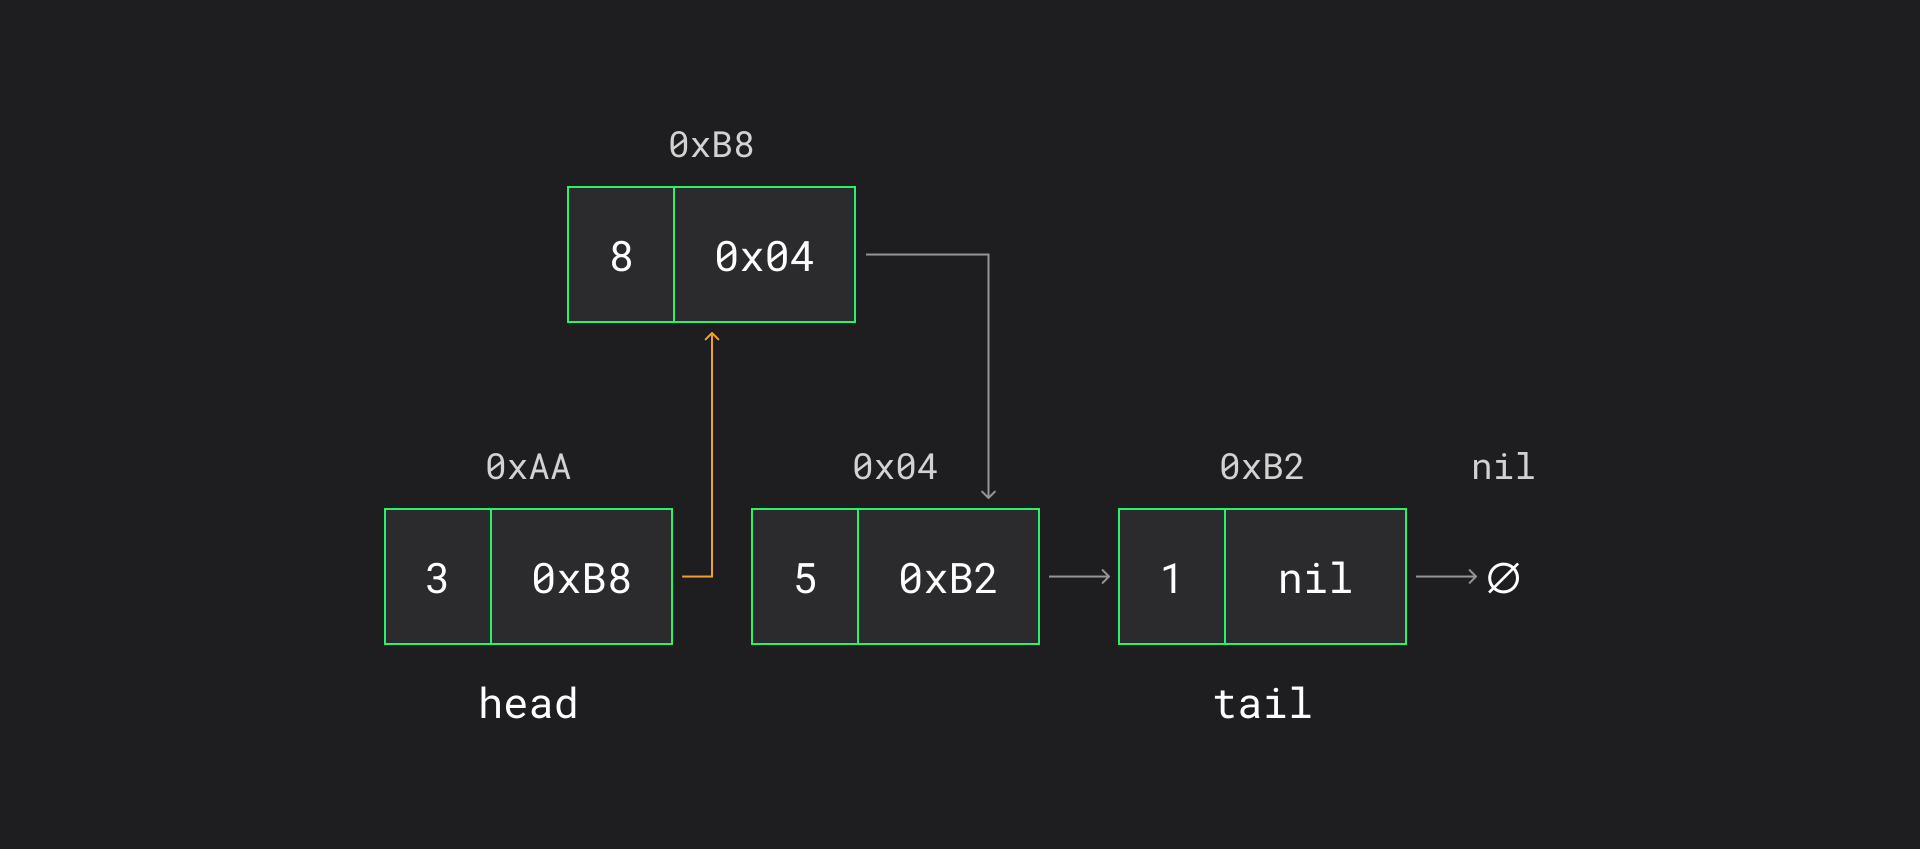
Затем смотрим, куда указывает элемент со значением «8» — на элемент со значением «5»
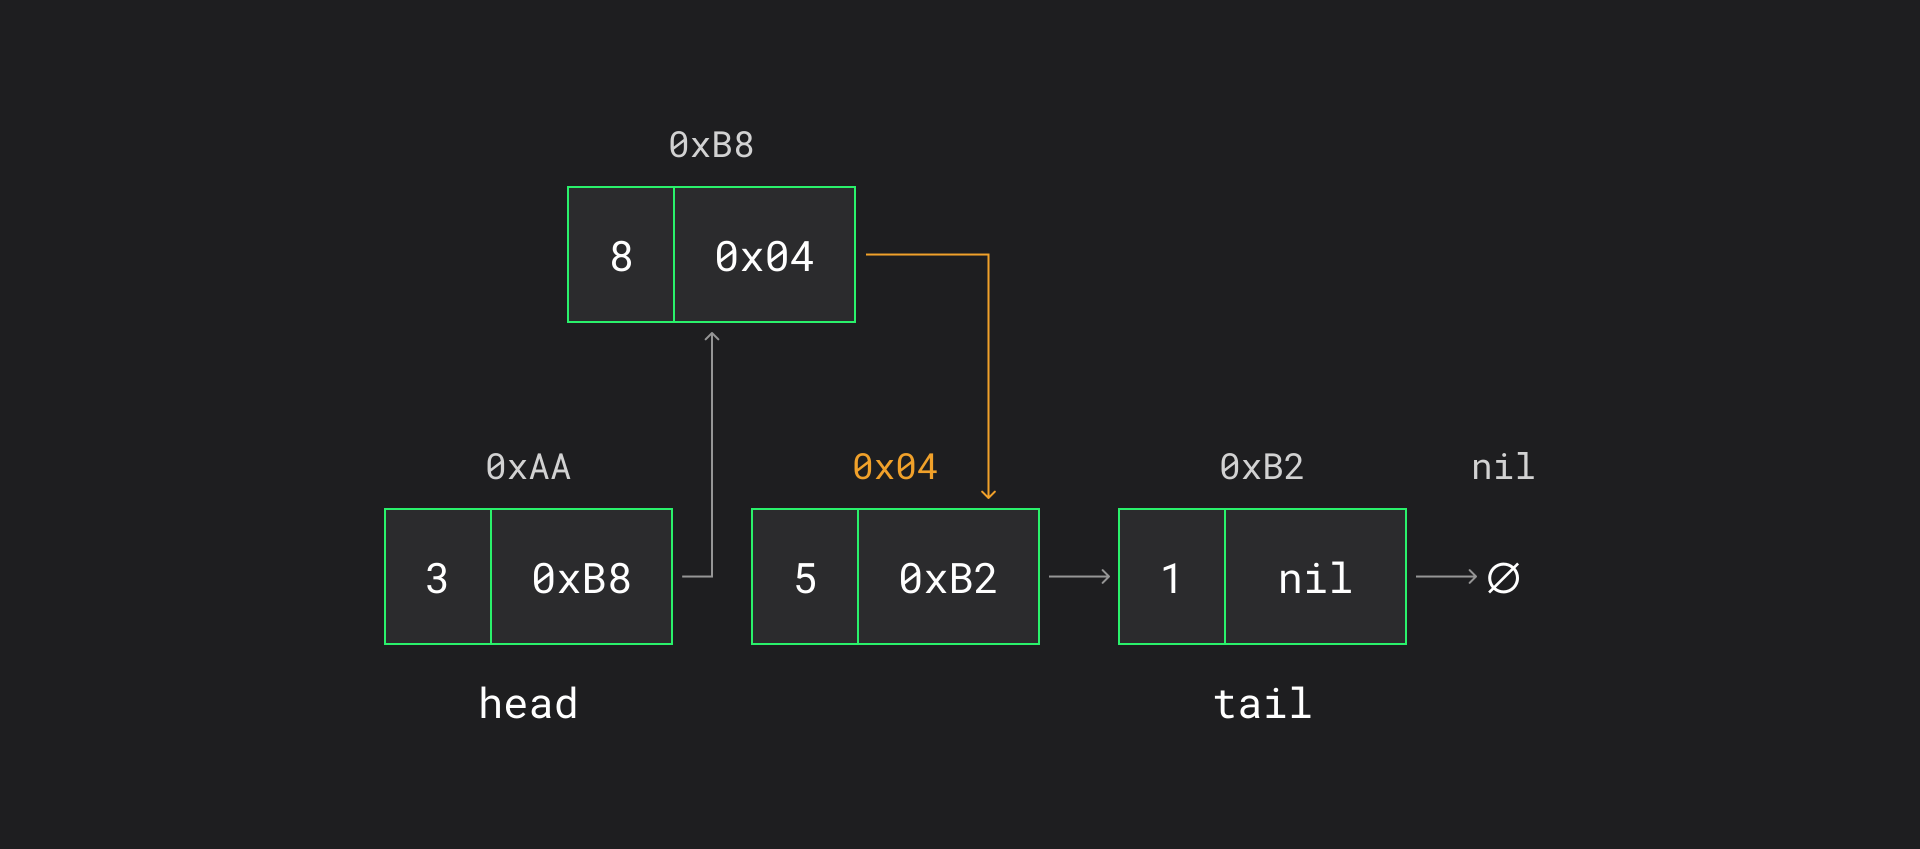
В итоге получаем нужный адрес (в нашем примере это 0x04) и меняем на него указатель.
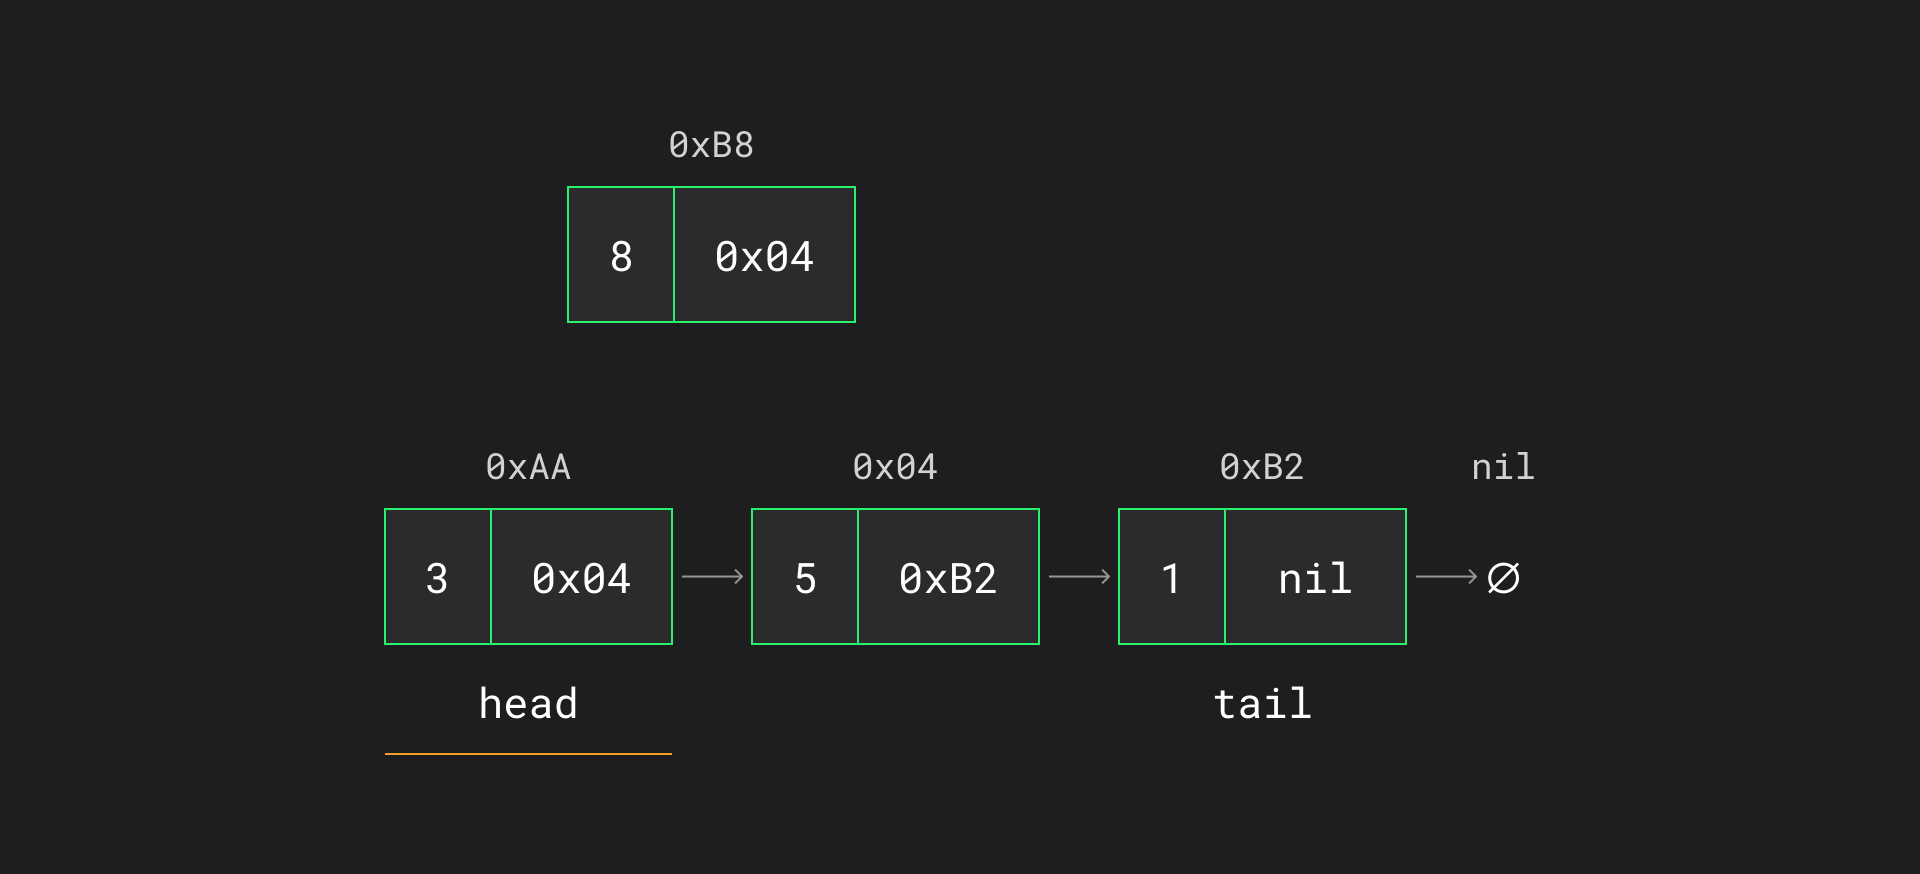
Значение в элементе head изменилось на 0x04 при смене указателя
После переназначения указателей удаляемый элемент перестает участвовать в структуре связного списка.
Удаляемый элемент перестает участвовать в структуре связного списка
В будущем при ручном управлении памятью потребуется ручное освобождение, а при при использовании сборщика мусора объект становится кандидатом на удаление автоматически.
Если у вас изначально есть указатель на предыдущий элемент, то сложность удаления из конца будет константной О(1) как по времени, так и по памяти, т. к. все, что нужно будет сделать — это обновить указатель.
Если у вас изначально есть указатель на предыдущий элемент, то сложность удаления из конца будет константной О(1) как по времени, так и по памяти, т. к. все, что нужно будет сделать — это обновить указатель.
6. Индексация и итерирование
После рассмотрения операций вставки и удаления может показаться, что связный список — универсальная структура данных. Действительно, большинство операций модификации выполняются за константное время.
Поэтому возникает вопрос: почему тогда не использовать связный список во всех случаях?
Причина заключается в особенностях хранения данных и способе доступа к элементам.
Рассмотрим, каким образом осуществляется доступ к произвольному элементу массива. Предположим, имеется массив data, и необходимо получить второй элемент. При этом индексация начинается с нуля.
Для вычисления адреса нужного элемента в массиве используется простая формула:
Рассмотрим, каким образом осуществляется доступ к произвольному элементу массива. Предположим, имеется массив data, и необходимо получить второй элемент. При этом индексация начинается с нуля.
Для вычисления адреса нужного элемента в массиве используется простая формула:
- адрес элемента = (адрес начала массива + индекс × размер элемента)
или
data[2] = *(ptr + 2 * size)
Если массив состоит из целых чисел (int), то размер элемента равен размеру типа int.
После вычисления адреса выполняется операция разыменования указателя, в результате которой получается значение необходимого элемента.
Подобный механизм возможен благодаря устройству оперативной памяти (RAM — Random Access Memory). Оперативная память предоставляет возможность обратиться к любому байту за одинаковое время, поэтому доступ к элементу массива выполняется за константное время — O(1).
Но будет ли такая операция работать со связными списками? Нет
В массиве элементы располагаются последовательно в памяти, поэтому адрес любого элемента можно вычислить по известной формуле
В связном списке элементы могут находиться в совершенно разных участках памяти. Один узел может располагаться по одному адресу, следующий — по совершенно другому, никак не связанному с предыдущим. Поскольку элементы не образуют непрерывную область памяти, вычислить адрес нужного узла арифметически невозможно
Единственный возможный вариант — последовательно пройти по цепочке указателей: начать с головы списка (head), перейти к следующему элементу, затем — к следующему и повторять переходы до достижения требуемой позиции.
Для получения элемента с номером N потребуется выполнить N последовательных переходов между узлами.
По этой причине операция обращения к произвольному элементу имеет:
Для получения элемента с номером N потребуется выполнить N последовательных переходов между узлами.
По этой причине операция обращения к произвольному элементу имеет:
- линейную сложность по времени — O(n);
- константную сложность по памяти — O(1).
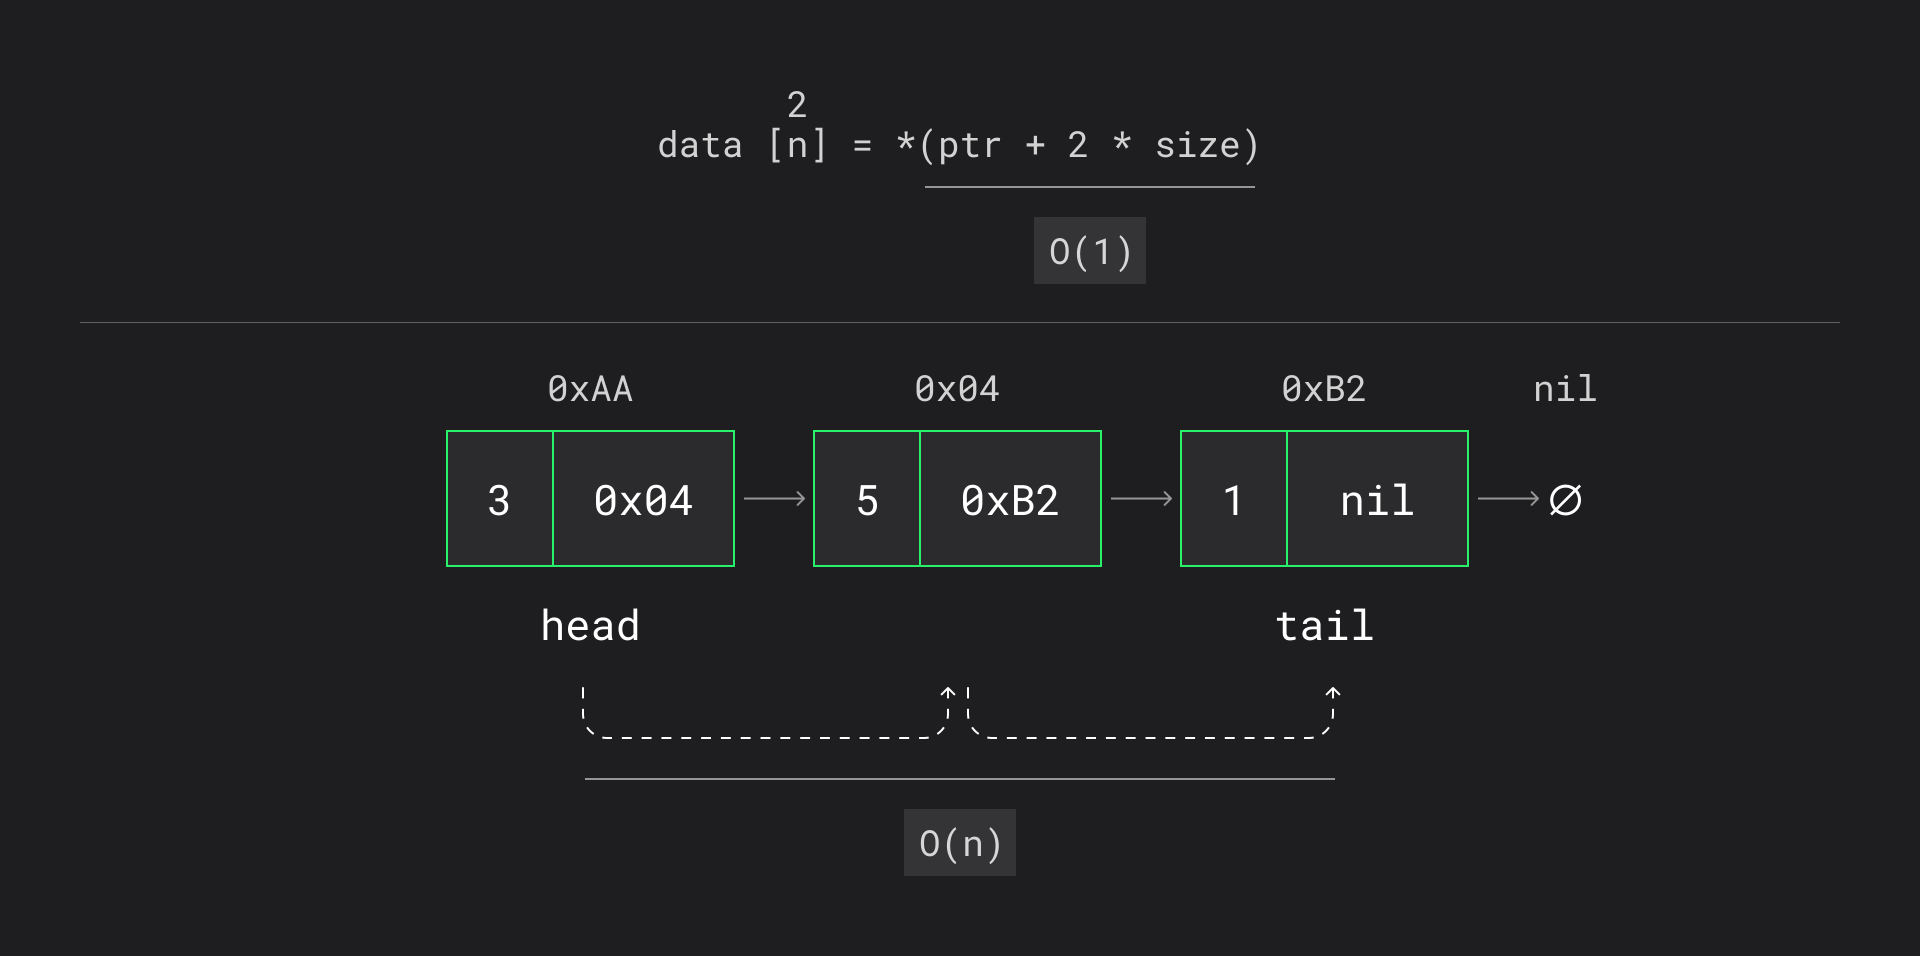
Для получения нужного элемента дополнительная память не используется, но время выполнения линейно зависит от количества элементов, которое необходимо пройти
Еще важно отметить, что при обходе массива элементы располагаются последовательно друг за другом. Благодаря этому процессор может заранее загружать соседние данные в кэш. Такое поведение называется хорошей кэш-локальностью. В результате при последовательном обходе массива большинство обращений выполняется не к оперативной памяти, а к быстрому кэшу процессора.
В связном списке узлы могут находиться в произвольных местах памяти, и каждый переход по указателю потенциально приводит к обращению к новой области памяти.
В результате процессор не может эффективно предугадывать следующие обращения. Данные значительно хуже кэшируются и чаще происходят промахи кэша. Такое свойство называется плохой кэш-локальностью.
Поэтому, несмотря на одинаковую сложность O(n), итерация по связному списку на практике обычно выполняется заметно медленнее, чем итерация по массиву.
7. Односвязный и двусвязный список
До этого рассматривался односвязный список, в котором каждый узел содержит только один указатель — на следующий элемент.
Пример односвязного списка
Такую структуру можно расширить, добавив еще одно поле — указатель на предыдущий узел.
В результате каждый элемент будет хранить:
В результате каждый элемент будет хранить:
- значение;
- указатель на следующий элемент (next);
- указатель на предыдущий элемент (prev).
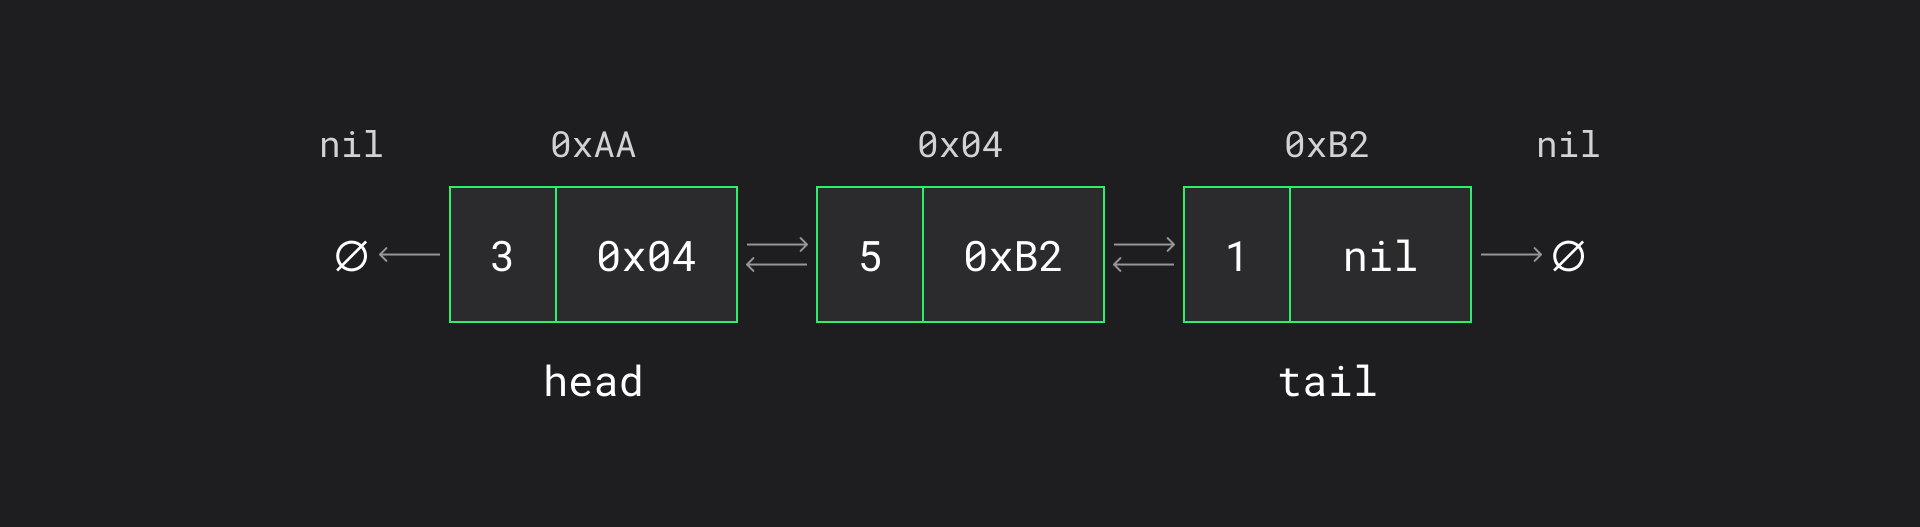
Пример двусвязного списка
Первый элемент не имеет предыдущего узла, поэтому его указатель prev содержит значение nil. Аналогично последний элемент содержит значение nil в поле next. Такая структура называется двусвязным списком (Doubly Linked List).
Наличие дополнительного указателя позволяет эффективно выполнять операции, которые затруднены в односвязном списке.
Появляется возможность:
За счет хранения обратных ссылок многие алгоритмы становятся удобнее в реализации, но дополнительная функциональность достигается за счет увеличения объема памяти. Каждый узел теперь хранит не один указатель, а два, поэтому на хранение структуры требуется больше памяти по сравнению с односвязным списком.
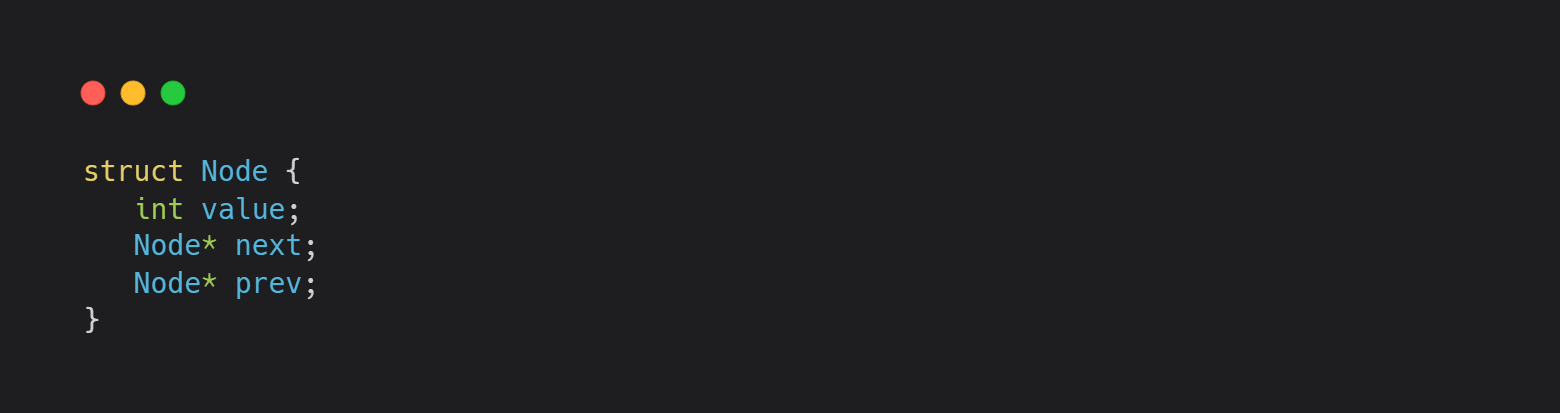
Пример структуры узла двусвязного списка на языке C++:
Наличие дополнительного указателя позволяет эффективно выполнять операции, которые затруднены в односвязном списке.
Появляется возможность:
- перемещаться по списку как вперед, так и назад;
- быстро получать предыдущий элемент;
- упрощать некоторые операции удаления и вставки.
За счет хранения обратных ссылок многие алгоритмы становятся удобнее в реализации, но дополнительная функциональность достигается за счет увеличения объема памяти. Каждый узел теперь хранит не один указатель, а два, поэтому на хранение структуры требуется больше памяти по сравнению с односвязным списком.
Пример структуры узла двусвязного списка на языке C++:
8. Преимущества и недостатки связного списка
Подводя итог, выделим несколько ключевых характеристик связного списка.
К преимуществам относятся:
К преимуществам относятся:
- высокая скорость вставки элементов (когда есть ссылка на элемент);
- высокая скорость удаления элементов (когда есть ссылка на элемент);
- отсутствие необходимости перемещать данные при модификации структуры;
- возможность эффективно изменять взаимное расположение элементов.
К недостаткам относятся:
- дополнительный расход памяти на хранение указателей;
- отсутствие быстрого произвольного доступа к элементам;
- низкая кэш-локальность по сравнению с массивами.
9. Применение связных списков на практике
Связные списки наиболее эффективны в задачах, где нужно часто модифицировать структуру данных.
Например, они хорошо подходят для реализации списка задач в системе управления проектами. Если задачи регулярно меняют приоритет, перемещаются между различными статусами или часто переставляются относительно друг друга, использование связного списка позволяет выполнять такие изменения без перемещения всех элементов структуры.
Еще одним примером является реализация очередей. Например, очередь запросов в колл-центре обрабатывается по принципу FIFO: первым обслуживается тот запрос, который поступил раньше остальных. После обработки первый элемент удаляется из начала очереди. Поскольку удаление первого элемента в связном списке выполняется за O(1), такая структура данных хорошо подходит для реализации подобных очередей.
Заключение
Связный список — это структура данных, оптимизированная прежде всего для частых модификаций. Он уступает массиву по скорости произвольного доступа к элементам и эффективности последовательного обхода, однако значительно превосходит его в операциях вставки и удаления.
Поэтому выбор между массивом и связным списком всегда определяется характером решаемой задачи: если требуется быстрый доступ к элементам — предпочтителен массив, если же структура данных постоянно изменяется — более эффективным решением становится связный список.
Если хотите подробнее разобраться в работе связных списков, то смотрите наше видео с наглядными примерами из курса по структурам данных.
Другие статьи